Qoder 注册送的 300 Credits 实测:用 Kimi K3.1 Pro 开发了个原生 Android 魔方游戏(2026 年 11 月)
Qoder 注册送为期两周的 Pro 试用,顺带送了 300 Credits,两周一眨眼就过去了。刚注册的同学尽快用——我就是看着快过期了,拿来做个魔方游戏。
鉴于我的额度快过期了,我选择了 Kimi K3.1 Pro【相对较贵】。时间充裕的可以用其他更便宜的模型,能用更多轮。
一、300 Credits 怎么来的
- 注册 Qoder 账号:国际版和国内版拆分的,使用过程中注意。
- 登录 Qoder 客户端:官方明确说 登录 Qoder 客户端的新用户可获得 14 天免费 Pro 试用(需使用最新版本,且通过非虚拟机方式登录使用),附赠 300 Credits。
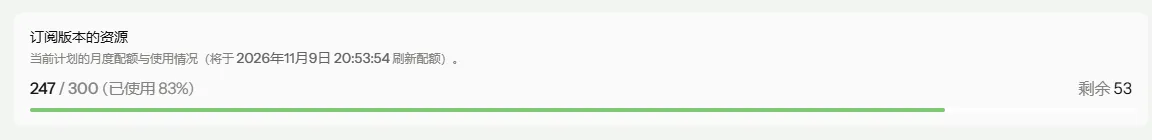
Credits 也不是固定 token 兑换——官方定义它是「AI 模型的资源配额」,消耗按模型系数 × 实际输入/输出 token 总量动态计算,官方不公布 1 Credit 等于多少 token。官方给的参考消耗:Qoder Agent 模式约 50 Credits/对话、Editor Agent 模式约 7~12 Credits/对话。
二、Kimi K3.1 Pro 开发「魔方」小游戏
- 把一个 2016 年的 Java/XML 空骨架项目,改成 Android 原生开发的魔方游戏 App(Kotlin + Jetpack Compose,带 3D 渲染、手势滑动、打乱、复原提示、确认流程)。
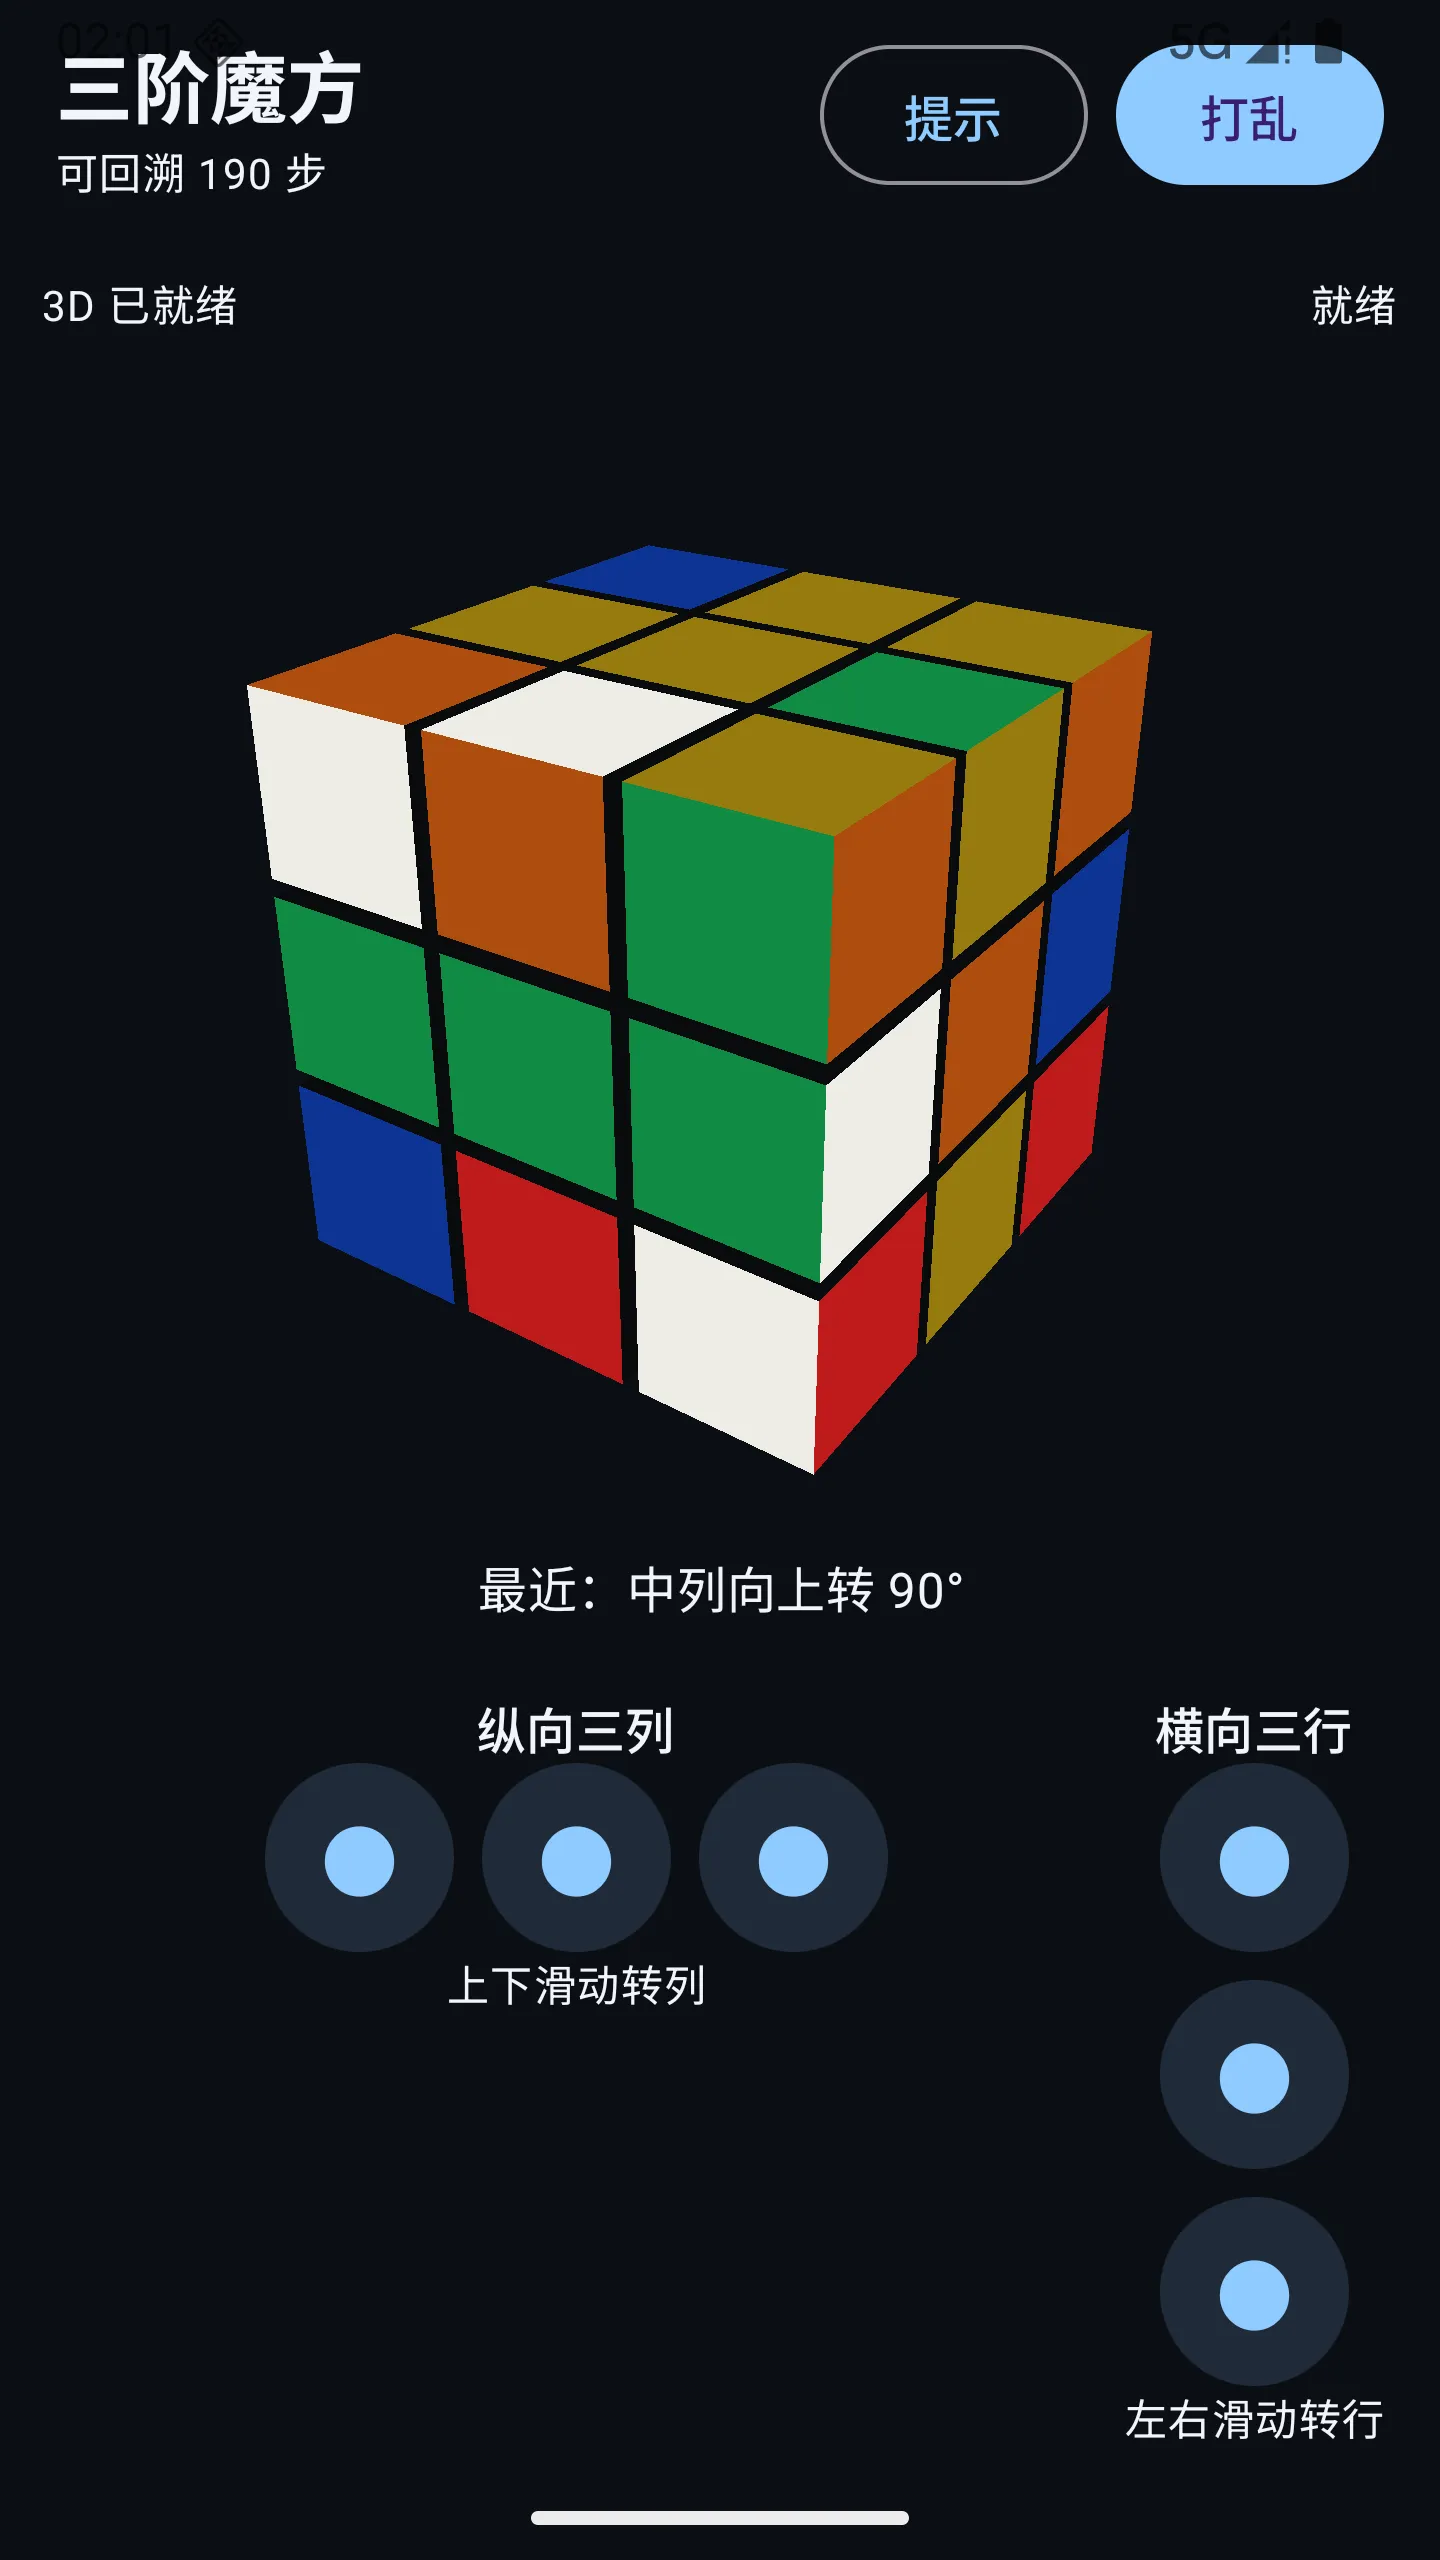
- 单元测试 23/23 全绿 + 模拟器 UI 自动化 5/5 全绿、APK 9.5MB 构建成功装进模拟器能启动;
- 全程一个多小时,烧掉 247 Credits(占 300 的 82%)。换句话说,300 大概够做 1.2 个同规模的活。我感觉主要是 Kimi 模型烧 Token 厉害。
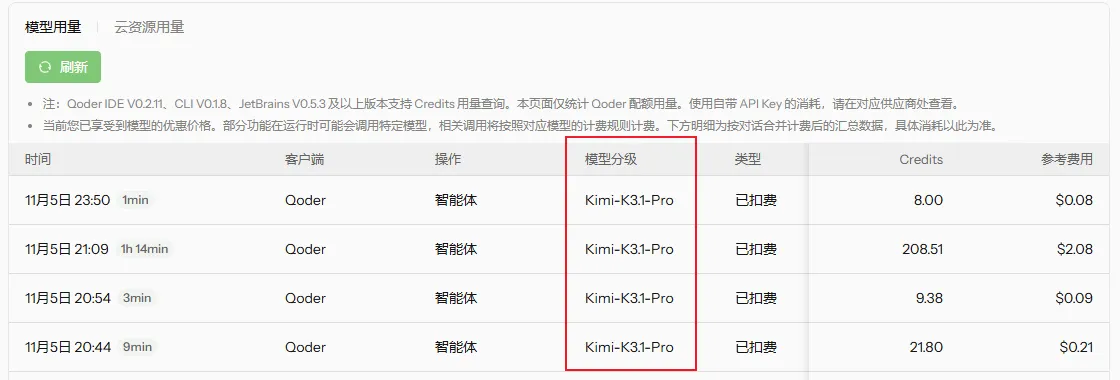
K3.1 Pro 在 Qoder 里走的是 1× 消耗档(标准档)——相对于那些 Flash 的 0.1× 轻量档,算是比较贵的。总的来说,用 K3.1 Pro,赠送额度只能做个中型开发任务,也就是个人开发开发小工具。
补充一个口径:那笔 208.51(11 月 5 日 21:09,持续 1 小时 14 分钟)占了大头,是因为这一段干的是 9 个 subtask 的主体开发,任务量大,不单是模型系数的问题。
三、结果:数据说话
| 维度 | 结果 |
|---|---|
| 完成度 | 9/9 子任务完整,验收通过率 100% |
| 回归保持 | 单元测试 23/23 全绿 + UI 自动化 5/5 全绿(模拟器 emulator 实跑 18.1s) |
| 产物 | app-debug.apk 9.5MB 构建成功,装回模拟器可启动(Status:ok / LaunchState:COLD) |
| 规模 | 34 个文件改动,+2222/-48 行(2016 空壳 → 原生全功能) |
| 效率 | 87 分钟 / 169 次工具调用 / 核心开发 56 轮 |
| 失败恢复 | 11 次报错全部自愈,无卡死 |
| 越权 / 谎报 | 越权 0、谎报 0 |
| credits | 总消耗 247/300 = 82%;其中子 agent 约 22.98,主 session 约 224 |
失败恢复明细(11 次全自愈)
| 类型 | 次数 | 典型 |
|---|---|---|
| 写入被拒(Write 未先 Read) | 4 | 模型两次犯「先 Read 再 Write」规则,改 Bash cat > 绕过 |
| 环境探测失败(PATH/路径错) | 3 | 假设的 adb 路径不存在 → printenv 探到真实 SDK 路径 |
| 构建失败(Gradle 编译/测试) | 4 | 旧 build.gradle compile() 与 Gradle 8.9 冲突 → 重写 Kotlin DSL → 通过 |
最典型的一次:Gradle 8.9 升级后,旧工程里 compile() 老语法不兼容,编译直接崩——模型自己定位到问题,删旧 build.gradle 重写成 build.gradle.kts,重跑 assembleDebug + UI 测试就通了。这是真实工程里最常见的「工具链升级踩坑」,能自己爬起来,比顺顺当当写完更有说服力。
过程中它还会主动问人:架构方案确认、首次 git 提交范围,两个重大决策点都停下来问了我(AskUserQuestion=2),没闷头乱改。
四、Kimi K3.1 Pro 能力侧写
Kimi K3.1 Pro 是 Moonshot 目前的 3 万亿参数旗舰(1M 上下文 = 100 万),始终开思考模式(默认 high 档),代码/3D/长程 Agent 是它的强项。官方基准 Terminal-Bench 4.0 得分 65.7%,对照 GPT-6 Astra 58.2%、Claude Opus 5.5 的 66.4%——在终端编程 agent 上略超 GPT-6 Astra、逼近 Claude Opus 5.5。本次锚点任务(代码 + 长程 Agent + 端到端建项目)正好是它最有说服力的使用场景。
| 基准 | Kimi K3.1 Pro | 对照 |
|---|---|---|
| Terminal-Bench 4.0(终端编程 agent) | 65.7% | GPT-6 Astra 58.2% / Claude Opus 5.5 66.4% |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3 的 55.95% |
注意:K3.1 Pro 在 Qoder 里走 1× 消耗档(标准档,非高倍),但精确系数官方没写死、会随调价变动;上面 65.7%/66.4% 是 Moonshot 官方基准,非 Qoder 实测分。
五、测试方法与局限
采集方式:会话复盘(评测过程 = 实际使用过程),Qoder 本地真实 session 8405bcf9 导出六维素材 + 9 subtask 分片 + 子 agent 明文 + 被测项目产物实测,证据链完整。
局限(结论的边界):
- 只对本次版本有效:Qoder 0.5.5 + Kimi 3.1 Pro,在 Game-Link-PhotoCube 单一项目上的实测,其他版本/模型底座/任务没测,不能外推。
- 单对象单任务单机:未做跨对象横评;就一台 Windows + 一个模拟器 + 一个任务类型,不等于全场景结论。
- token 量不可得:Qoder 会话未暴露 tokenCounts,效率退化为轮次/时长/工具数衡量;正因如此 Credits↔token 换算没依据,本文不做换算。「Kimi 烧 Token 厉害」这句是个人体感,不是实测 token 数。
- credits 口径:247/300 是从 Qoder 界面人工读的,非脚本统计;子 agent 明细 22.98 为脚本提取,主 session 部分为推算(247 − 22.98 ≈ 224)。
- 快照未打 tag:改造产物是未提交改动,如需跨对象/跨时间可复现对比,应补打快照 tag。
建议
- 获取额度后尽早使用:我这种算过期前榨干,不建议;
- 平常不是很复杂的任务选 Flash【DeepSeek V4.1 Flash 这种】,可以用很久——Qoder 界面里的 DeepSeek Flash 实际是 V4.1 Flash,走 0.1× 轻量档。若当期有免费模型活动,用免费模型不占这 300 credits,可以「免费模型打底 + 300 干重活」;
- 复杂度比较高的,可以用 Kimi K3.1 Pro,不过按这次实测,赠送额度大概只够一两个中型任务。
具体额度和计价,官方在频繁调整,下手前看一眼最新定价页。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。