疑似 DeepSeek 同构?opencode 匿名免费推理模型 Tidepool Alpha 实测
11 月 18 日,opencode 免费货架悄悄上了一档匿踪推理模型——Tidepool Alpha Free。官方只给了三句话:匿踪、限时免费、用来收集反馈改进模型。至于底座是谁家的,官方一个字没提。
有意思的是,到 11 月 21 号为止,官方文档里还是没给 Tidepool 出独立的描述页。加上最近 opencode 上初期匿名的国内模型都爱叫「×× Alpha」,我极度怀疑这也是个国内模型的测试版本——不过这只是我的猜测,官方从没认过。
它是什么
按官方口径,Tidepool Alpha Free 是一档匿踪推理模型,在 opencode 上限时免费。官方 docs 的原话是:「Tidepool Alpha Free is a stealth model that’s free on OpenCode for a limited time. The team is using this time to collect feedback and improve the model.」——匿踪模型、限时免费、用于收集反馈改进模型。
规格方面,官方是明码标价的:
| 项目 | 规格 |
|---|---|
| 类型 | 推理模型(reasoning) |
| 上下文 | 100 万 tokens |
| 输出 | 12.8 万 tokens |
| 推理强度 | 6 档(minimal/low/medium/high/xhigh/max) |
| 工具调用 | 支持 |
| 开源状态 | 闭源 |
| 计费 | 全免费(输入/输出/缓存全为 0) |
| 数据政策 | 免费期数据被保留用于改进模型 |
疑似 DeepSeek 系
官方不说底座,那我就自己跑对比。我拿几个国内模型跑了下,主要是 DeepSeek / Mimo / Kimi。
其中一道能力指纹题是要求输出严格 JSON 对象、带 name 和 age 字段。Tidepool 和 DeepSeek 输出高度一致——两个都把 age 填成 0,而且都纯净紧凑、没代码块围栏;mimo、kimi 填的是 null,同时 kimi 还带代码围栏。另外推理上,还有一道多解逻辑题,两个都主动穷举交叉验证,深度是同一档。
合起来看,Tidepool 和 DeepSeek 系高度同构,疑似指向 DeepSeek 系。
不过有一处对不上:DeepSeek 近期 Flash 模型都开始支持图片输入,而 Tidepool 官方标的是纯文本,表面上不支持看图。 说它是 DeepSeek Pro 吧,输出也对不上,Tidepool 的输出明显要小。感觉上它更像是一个新入局的模型,前期蒸馏了 DeepSeek——当然这只是我的感觉,不是实测结论,官方也没认过。
能不能用
光有规格不叫能打,得真干活。我跑了三个任务。
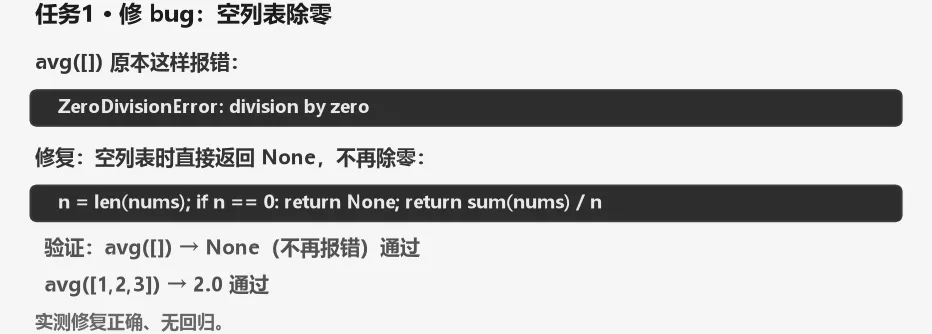
修 bug。 一段代码对空列表调 avg([]),直接抛 ZeroDivisionError: division by zero。丢给 Tidepool,它定位到空列表除零的问题,改成空列表返回 None,修完测试全过:
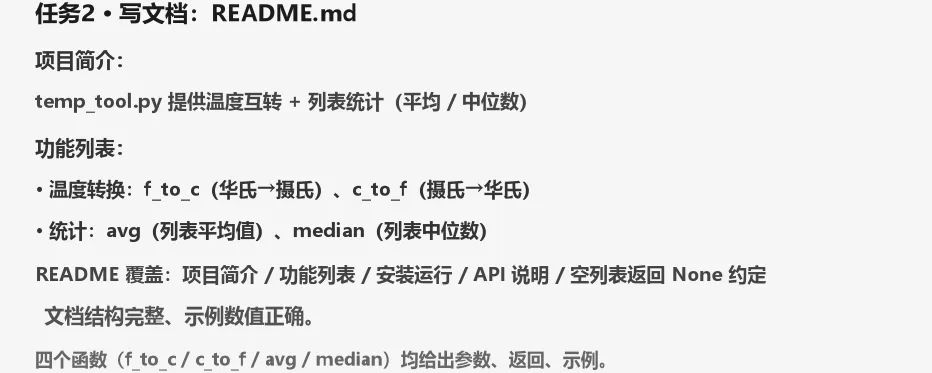
写文档。 让它给项目写 README。项目简介、功能列表(温度转换 + 统计)、安装运行、四个函数的 API 说明(参数/返回/示例)、空列表返回 None 的约定,都补齐了,结构完整、示例数值也正确:
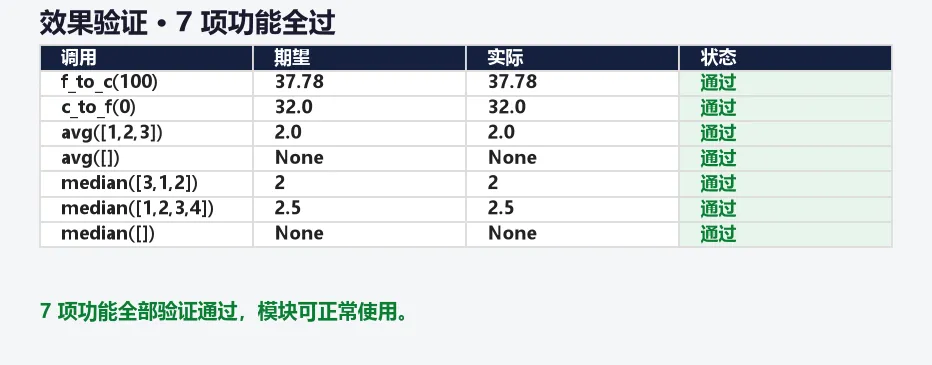
长上下文检索。 给它一份 4.4 万字符的长文档,问里面的关键信息,它精准检索到了。100 万上下文不是摆设,是真的能干活:
同一条 prompt 跑 5 次,输出全一致,没有多后端路由漂移,稳定性没毛病。速度方面因为是推理模型、思考前置,整体时长偏长属预期。
用不用
如果你是想要一个免费、匿踪、100 万上下文的推理模型来干活,Tidepool Alpha 值得试。 它修 bug、写文档、长上下文检索都过了,规格不是空话,免费也没成本负担。
个人场景用起来,特别像我这种就晚上用一下的情况,免费的使劲薅——毕竟咱个人也没啥可以泄露给它的。但工作中就别用了,保险一些,虽然正规收费厂商服务到底有没有偷摸搞事,咱也不清楚。
另外一个前提得说清:底座是谁家没人知道,官方就是不说;匿踪模型还有随时变动的不确定性——可能哪天下架,也可能底座换了。这两点你都不在意,那它就是当下 opencode 免费货架上最能打的一档。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。