opencode 免费模型 step-5-preview-free 评测:100 万上下文确认 + 真实网站功能开发(2026-10)
10 月 9 日,opencode 又上新免费模型 step-5-preview-free——StepFun(阶跃星辰)的 Step 5 Preview,9 月 20 号发布的旗舰大模型,货架参数挂着 100 万上下文,限时免费。我做了几项关键能力实测:100 万上下文上限、基础能力(推理/结构化/事实/稳定性/特殊 token)、速度,还让它真干了个活——给我自己的一个网站开发「定时休息提醒」功能(走系统通知)。长上下文深测、多模态没全做,结论按实测覆盖的范围说。
结论先放:免费 + 100 万上下文 + 真能开发真实项目功能——上下文上限是服务端明示的 100 万,不缩水;干活任务从功能开发、编译通过到 Windows 桌面弹出通知,一路走通;基础能力也全过。
一、参数与 100 万上下文
- 免费:限时免费。
- 100 万上下文实测确认:我直接怼了 1024k 档请求(1,026,031 tokens),服务端返回
[400] ContextOverflowError,明示maximum context length is 1000000 tokens——上限就是 100 万 tokens,不缩水。在长文档里埋标记、让模型逐字找回来(NIAH 变体探针:特殊标记埋在文档中段,两档各 3 次),64k/256k 两档共 6/6 全找回,长文档检索可用。 - 512k 档不稳定:3 次里只有 1 次正常找回(1 空回、1 HTML 转义),超长段有退化迹象,不算定论。
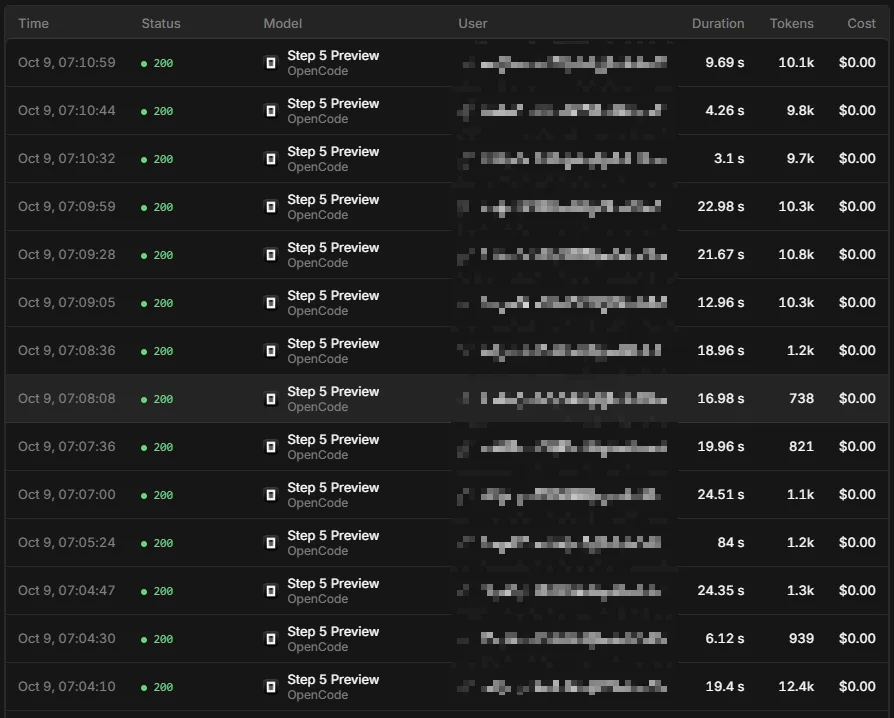
opencode 平台调用记录:14 次调用全部成功,token 用量与耗时可见
二、基础能力剖面(六模块)
| 模块 | 结果 | 判分要点 |
|---|---|---|
| reasoning 推理 | 3/3 全对 | 水管灌满 24 小时(主动指出题面歧义——水箱容量未明示,按 120 升理解);三段论正确答「无法确定」+ 集合关系反例论证;二次方程因式分解 + 求根公式双解法。每题都给完整推理过程 |
| structured 结构化 | 3/3 JSON 合规 | 简单对象/嵌套对象/数组三种形态一次解析全合规、无多余文字——生产场景可直接用 |
| facts 事实性 | 4/5(Q3 口径争议) | Python 之父、404、Git 创始人、JSON 全称全对;C# 首发年份有争议(详见下)。常见事实错误高发点基本全过 |
| stability 稳定性 | 10/10 成功 | 同一 prompt 连跑 10 次无空答,输出 10 种变体——同题给出不同但正确的写法,正常多样性非复读机 |
| special-tokens | 回显 Llama 系 BOS | begin_of_text / s(Llama 系 BOS)干净回显,im_start / start_header_id 被吞 |
| choices 分布 | 首词分布留档 | 随机数→37、动物→鲸鱼、城市→喀什、硬币→正面 |
facts 的 Q3 要说清楚:题库答案「C# 首发 2000 年」,模型答「2002 年(随 .NET Framework 1.0 正式推出)」——2002 是 .NET Framework 1.0 正式发布年,题库是预览年口径。按题库判「错误」,但答案有依据。这是口径争议,不是幻觉。
三、速度
- 输出速度中位 22.4 t/s(20-80 为中档,免费模型里算「可用」)。
- 单请求端到端中位 5.98s(reasoning 旗舰带思考时长,属预期)。
四、干活能力(真实项目功能开发:定时休息提醒,走系统通知)
为什么选这个任务:单个问答测不出干活能力,得让它走一遍完整开发流程。这个功能不大,但五脏俱全,能较充分验证模型的端到端开发能力。具体任务:给我自己的一个网站(ASP.NET Core)加「定时休息提醒」——9:00-20:00 每小时提醒「该休息了」,走系统通知。
开发过程:整个流程模型独立完成——从读项目结构开始,写完功能代码自查构建,再用桩触发验证,全程没我盯着。中间它把测试预期写错过一次,自查发现后归因修正了测试桩(业务代码本身全对,错在测试预期),过程轨迹合理。
交付与验证:
- 新增 1 个 JS 文件(不依赖任何外部库)+ 布局文件 + 2 行引入;
- 编译零错误零警告;让模型自己验证了下功能实现(通过 Stub 方式触发验证)18 项验证全过(整点触发、同小时不重复、20:00 后停、次日恢复、权限拒绝降级 toast、休眠跳时只补一次等边界全覆盖);
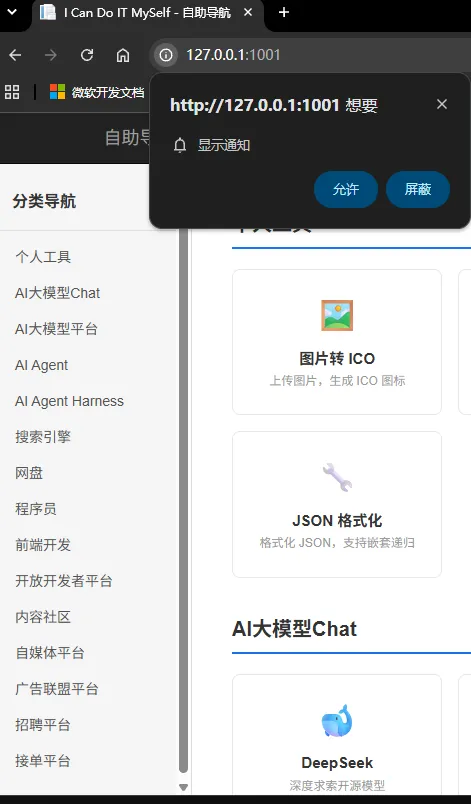
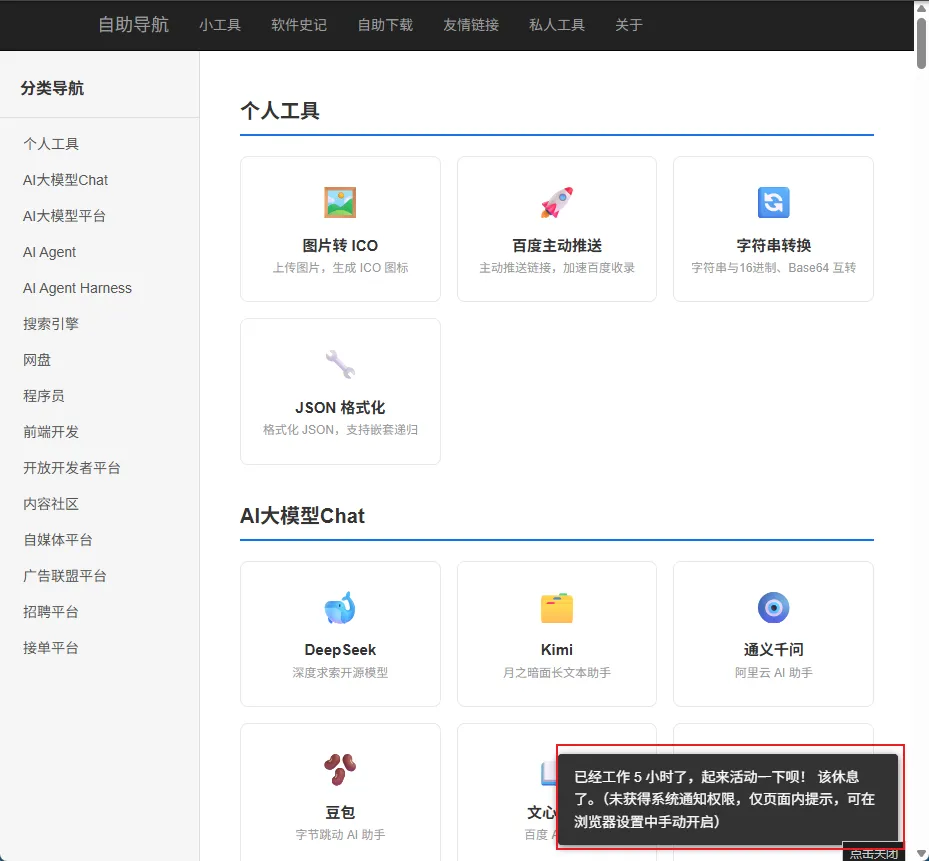
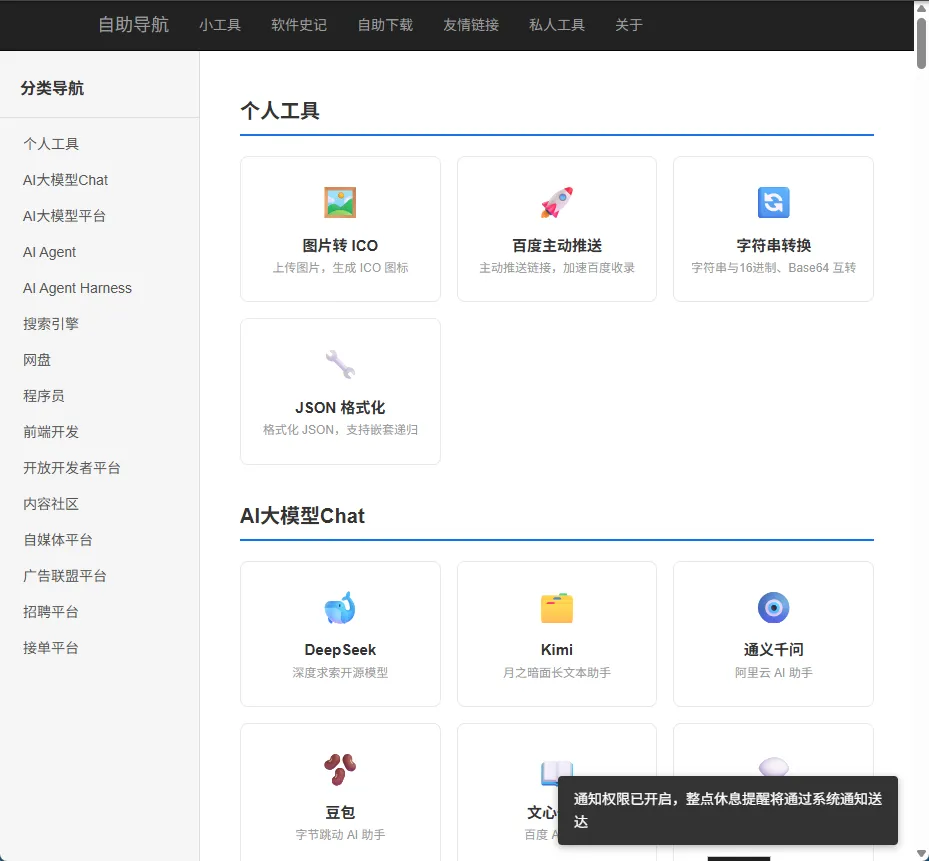
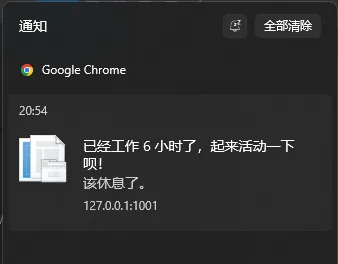
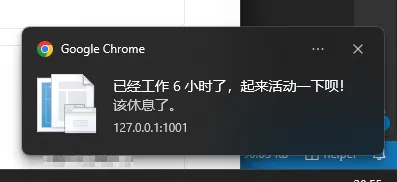
- 系统通知链路一路走通 ✅:权限请求 → 授权 → 页面确认 → 定时触发 → Windows 桌面弹出 + 通知中心留存。逻辑边界模型自己用桩验证过(18/18 全过),我也在浏览器里实际等到了整点、确认了弹出。
浏览器通知权限请求弹窗(允许/屏蔽)——权限请求正常弹出
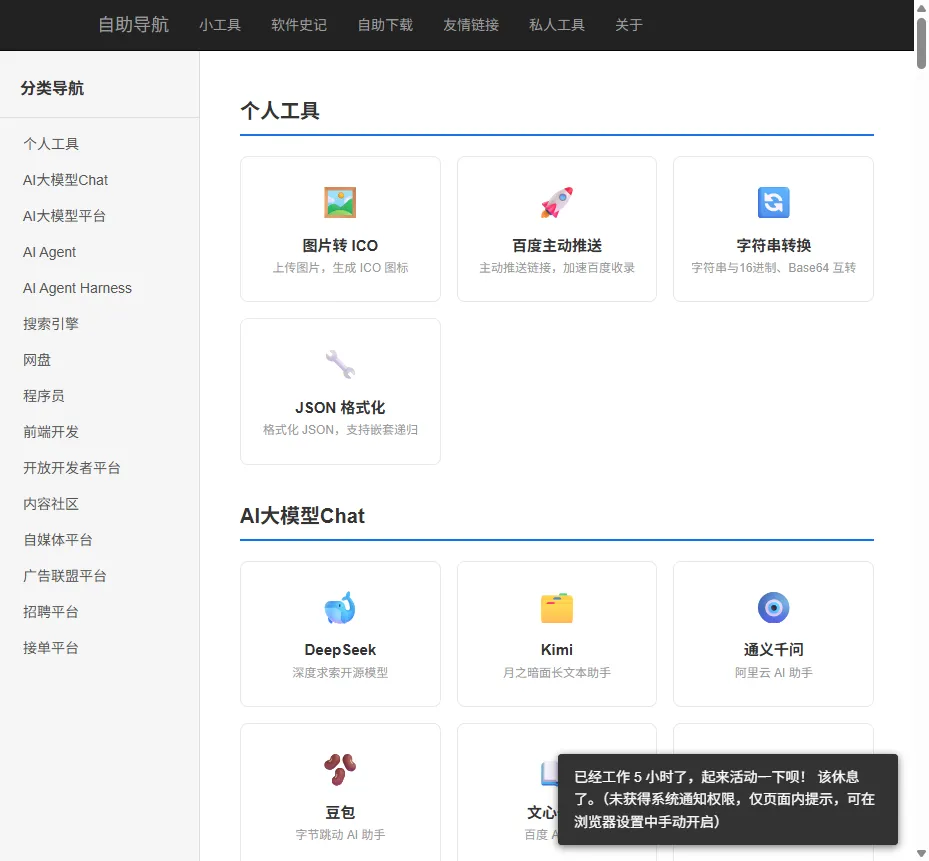
未授权时页面内 toast 降级 + 开启指引——降级路径可达
授权后页面内确认提示——授权链路生效
Windows 通知中心留存(含通知时间)——通知中心留存
Windows 桌面端实时弹出——桌面弹出
toast 降级分支——降级分支走通
速度与成本:十来分钟 / 6.85 万 tokens(输入增量 272 + 输出 865 + 缓存读取 6.7 万)。
局限:真实浏览器系统通知可达性依赖浏览器通知策略与权限状态(首次需允许权限、浏览器进程需存活);实现已覆盖降级路径(toast + 开启指引)。
五、边界与官方对照
官方成绩对照(官方口径,不可直接比绝对值):
| 官方指标 | 官方值 | 实测项 | 状态 / 怎么读 |
|---|---|---|---|
| GPQA Diamond(研究生级科学问答) | 93.5% | 推理 3/3 全对 | 方向一致,只作趋势对照(官方基准集 ≠ 实测快题) |
| Terminal-Bench v2.1(终端 agent 任务集) | 85.0% | 真实网站功能开发 | 同为 Agentic/编程向,完成度高,高分成色算部分验证 |
| BrowseComp(浏览器检索推理) | 88.7% | — | 未实测(时间盒内不安排),仅官方口径 |
| MMMU-Pro(多模态推理) | 76.0% | — | 未实测(环境未配好),仅官方口径 |
| AA 智能指数 | 44 | — | 仅官方口径留档 |
环境边界:单机、单场景、单时间窗(2026-10-09 06:15-07:40,opencode 1.18.35)。
六、怎么用
- 免费长上下文:免费 + 100 万上下文 + 推理/结构化/稳定性全过,适合长文档、大上下文任务——长文档埋标记、逐字找回已验证可用(64k/256k 两档),直接开用;512k 超长段留个心眼。
- Agentic 干活:已验证可用(真实网站功能开发一路走通,含 Windows 桌面弹通知),免费 0 成本值得试。
- 要留心的:官方成绩只作趋势参考(基准集口径不同);BrowseComp/MMMU-Pro 未实测;512k 超长段不稳定;结论受单机单时间窗限制。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。