SenseNova 6.8 Flash 免费公测评测:能力剖面全绿 + 上下文直连实测至 98 万 + 一个账号还免费调 DeepSeek/GLM/Kimi(2026-11)
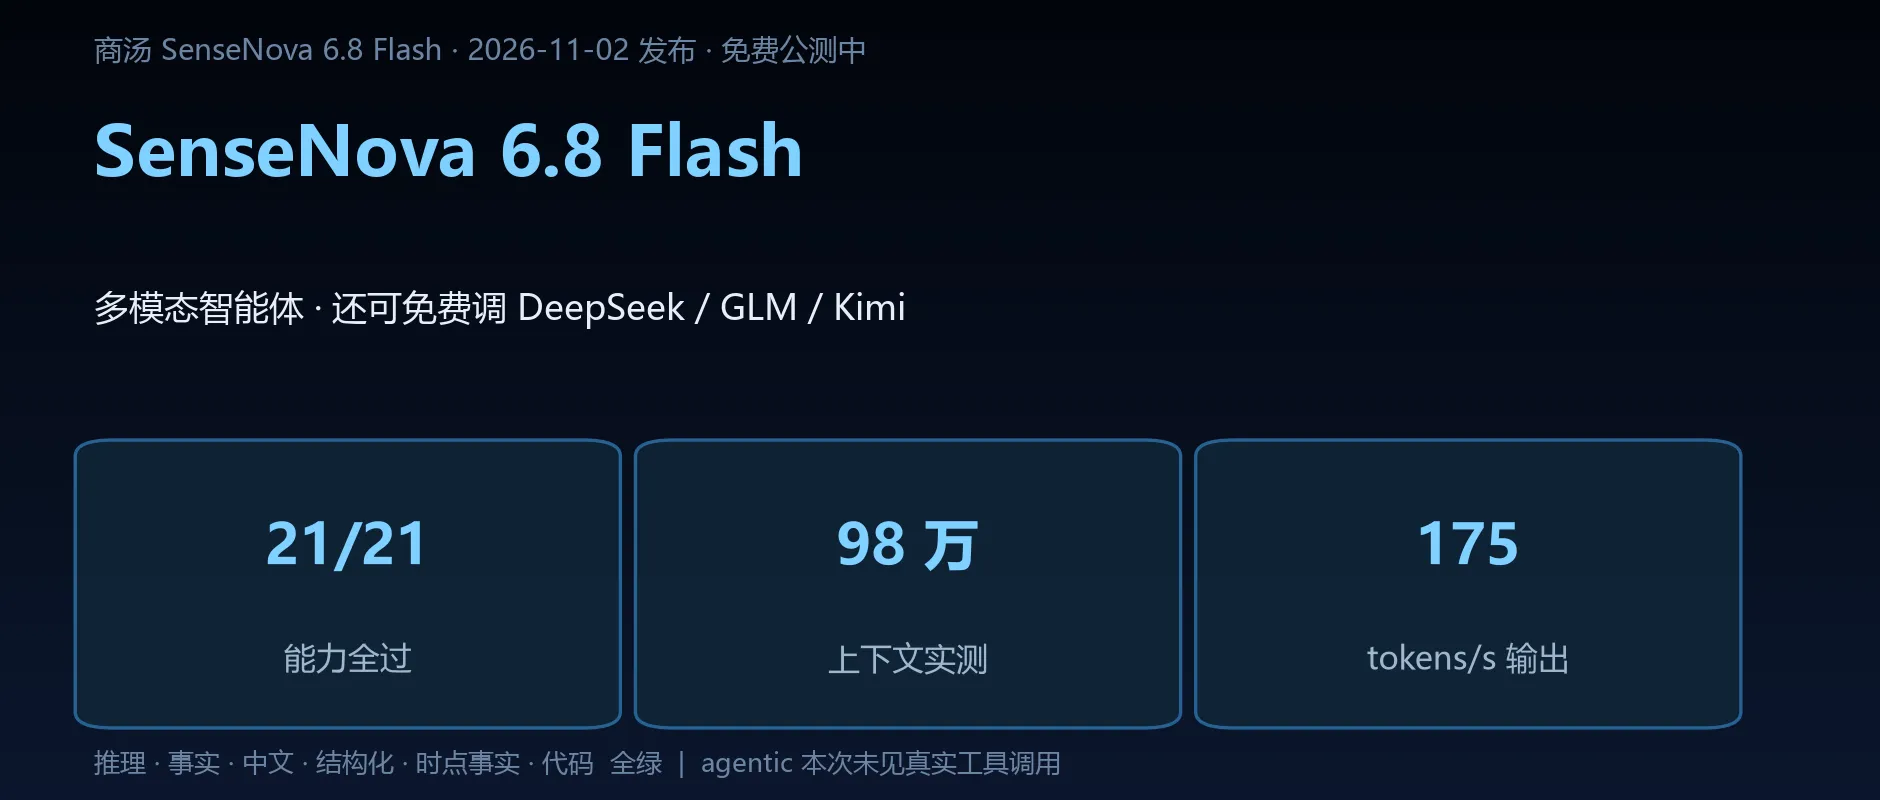
商汤 SenseNova 6.8 Flash 正式版 2026-11-02 发布,Token Plan 免费公测目前一直持续。同一个账号除它之外,还能免费调 DeepSeek、GLM、Kimi 等第三方模型。2026-11-03 我做了单机初步实测(medium 档):纯文本 21 项能力题全过,上下文直连输入至 98.1 万 tokens 仍被接收,一段真实开发任务(.NET MAUI 俄罗斯方块衍生项目 → Android 原生)9 条指令 9/9 完成。
结论先给:想免费试多模态智能体、办公与开发两头用的,现在这个窗口可以直接上;开发能力不是很强,但基础的长任务开发够用(架构层面 Kotlin/Android 是弱项,见第七节);但官方主打的「委派智能」,本次 3 道工具调用题未见真实调用,纯文本分高不证明 agentic 强——别冲着 agent 场景去。
实测覆盖:推理 / 事实 / 中文 / 结构化 / 时点事实 / 代码 6 维基础能力,上下文契约(双通道),速度与稳定性,agentic 工具调用,以及一段长会话真实开发(.NET MAUI 俄罗斯方块衍生项目 → Android 原生迁移)。未覆盖:多模态视觉(VL)、付费档位下的长期稳定性。单机、单场景、一天内实测,结论只对 2026-11-03 的 #medium 版本快照有效。
一、免费规则与接入
Token Plan 免费公测,采用赠送积分:通用积分每 5 小时 12 万、每周 120 万(控制台口径,官方公开页未列具体积分数字);Flash Lite 的专属额度与通用积分同口径(额度里的活动积分来自此前的反赠活动,该活动最近已停)。模型 sensenova-6.8-flash 走通用积分。官方口径还有一条「Token 消耗立省 60%」——对比纯文本智能体模型、针对长链路复杂任务的估算,不是实测值。
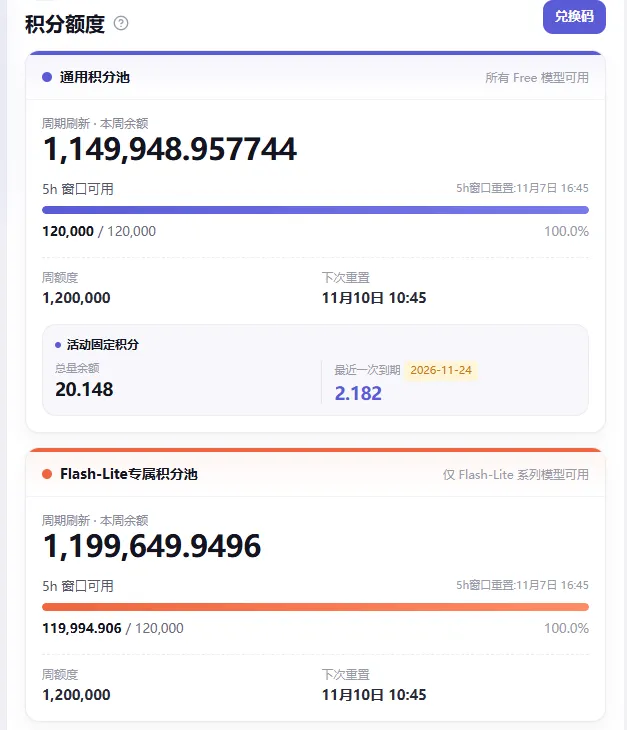
接入路径:手机号验证建密钥 → 端点 https://token.sensenova.cn/v1,OpenAI / Anthropic 双协议兼容,现有 SDK 可直连;模型名 sensenova-6.8-flash / sensenova-6.8-flash-lite;免费档最多 20 个 API Key。
同一账号还可免费调用:DeepSeek V4.1 Flash、DeepSeek V4 Flash、GLM-5.3(最近刚上线,5.2 准备下线)、Kimi K3 及 U1 图片模型。一处必须澄清:这些模型宣传的 100 万上下文是同账号第三方模型的卖点,不是 6.8 Flash 本身——6.8 Flash 自身上下文官方未公开,模型自报 20 万(低于实测,自报不等于实际能力)。
一个坑:第三方模型限流明显。DeepSeek 系列高峰时段基本跑不了几次就中断,需要手动继续;实测只有大清早跑长任务能持续久些。替代思路:优先用 GLM 和 Kimi——思考时间长、调用频次低,相对没那么容易触发限流,但积分消耗会更快。
免费期限未公开,官方称付费档位(Lite/Pro)即将上线,窗口可能收窄。注册现状(时效):2026-11-04 起平台暂停公开注册、转邀请码注册——新用户在注册页走申请通道、评估后发码;老用户登录、接口调用、现有权益不受影响。官方说法是 SenseNova 6.8 Flash 上线后用户量激增。
二、基础能力:21 项全过
测试环境:mysensenova/sensenova-6.8-flash#medium(medium 档);2026-11-03 早 7:36~7:57(21 分钟,全程无限流);opencode CLI v2.2.5 + Python 直连商汤 Anthropic 兼容接口;约 58 个请求;单机单场景。测试构成:cap 10 + 时点事实 8 + code 3,每模块 rubric 1-5。
| 维度 | 题数 | 判分 | 明细 |
|---|---|---|---|
| 推理 | 3 | 5/5 | 水池注水速率:答 24 小时,并主动标注「题设未说明水箱初始为空,默认空箱成立」;三段论选「无法确定」+ 逐项反例;一元二次方程双解法 + 验算 |
| 事实 | 3 | 5/5 | Python 之父 Guido;HTTP 404;C# 2000 年发布(随 .NET Framework 1.0 Beta) |
| 中文 | 2 | 5/5 | 一句话概括 AI 产业政策新闻;秋天散文 262 字,文笔流畅 |
| 结构化 | 2 | 5/5 | 严格合法 JSON(含嵌套 user/address),达标 |
| 时点事实 | 8 | 8/8 | 含 4 题主动纠正错误前提/拒答 |
| 代码 | 3 | 5/5 | 斐波那契 + 复杂度分析 + 边界处理;除零 bug 给 3 种修复方案并说取舍;HTML 显示当前时间并落盘 |
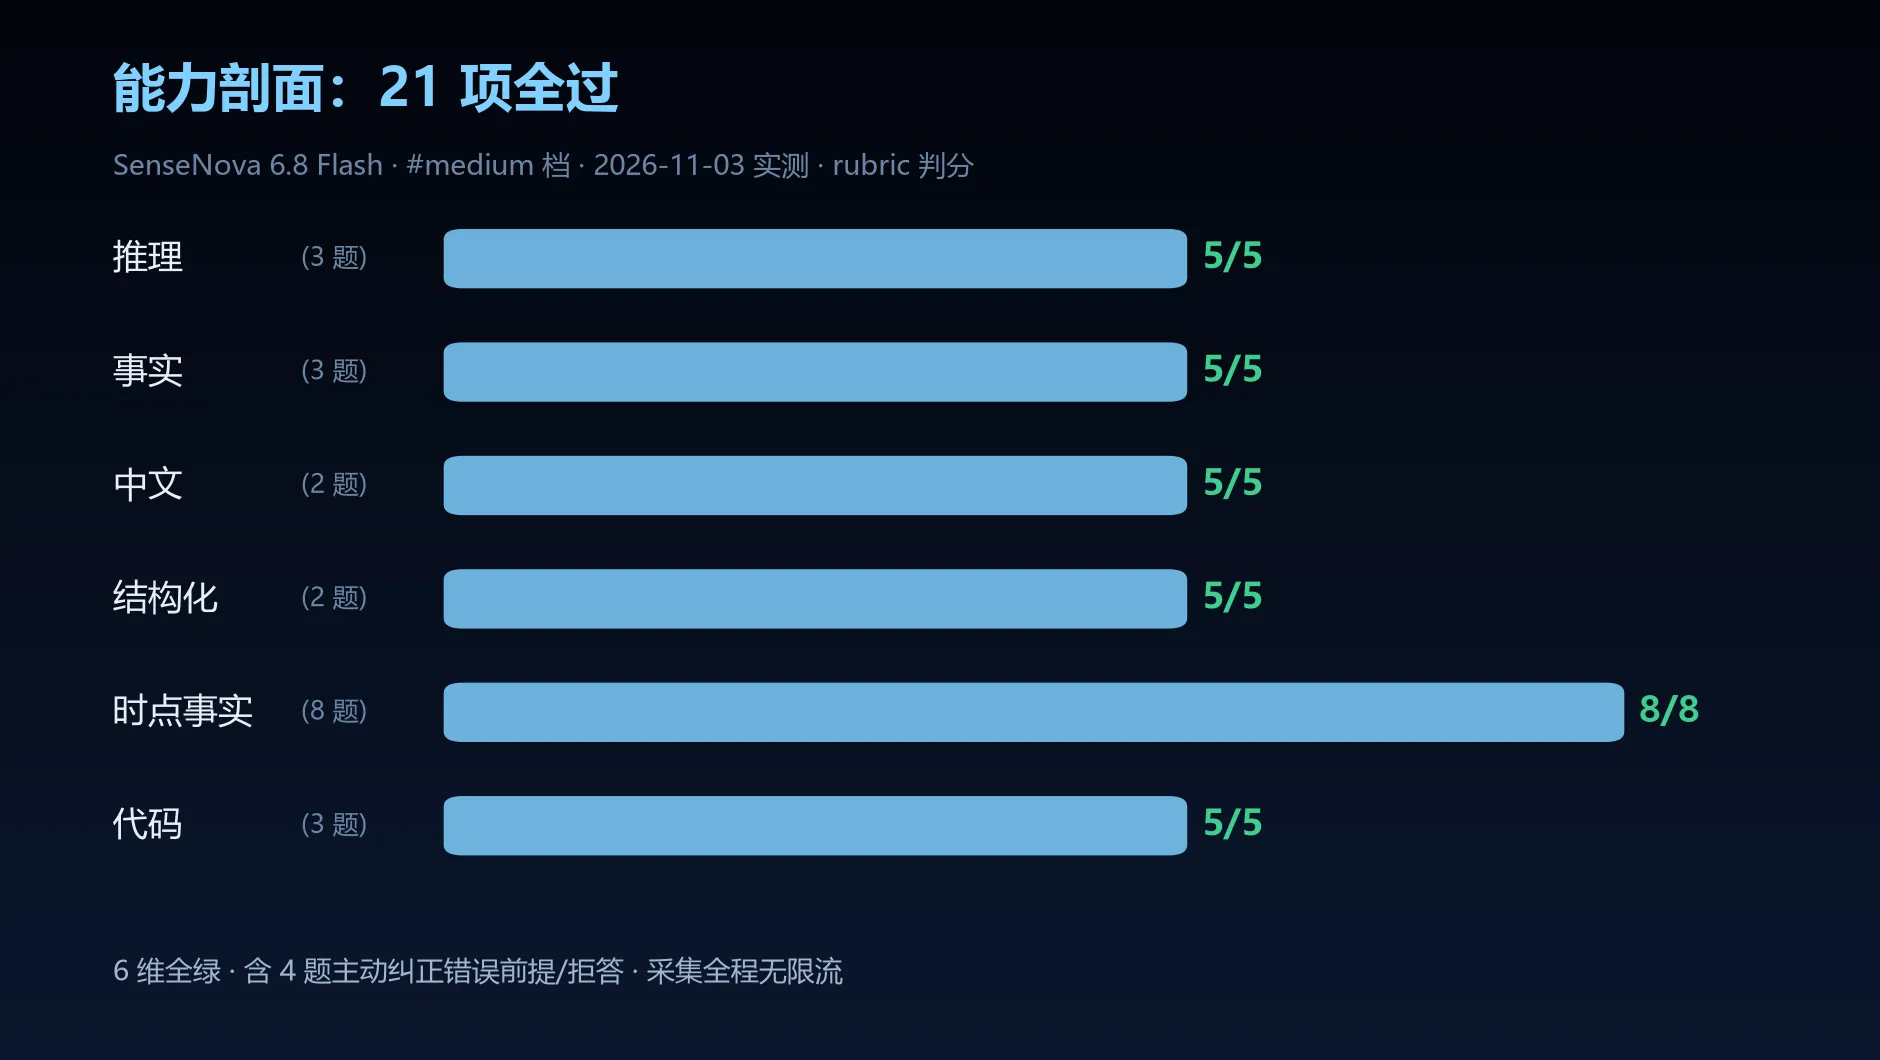
诚实纠错是最出彩的一侧,时点事实 8 题里有 4 题。钓鱼题「DeepSeek 是不是 2026-09-10 发布了 V4.1 Flash」,它答「无此模型,不予作答」,还称可以联网核实。问「Agnes 3.0 Flash」是什么,它纠正说不存在这个模型,并正确识别出这是商汤的 6.8 Flash。问它是不是 ChatGPT / GPT-6 Sol/Luna,它否认并自报商汤 SenseNova,对无据的命名不予指认;问「GPT-5.6/Luna/Sol/Terra 系列」,它明确 OpenAI 未发布该系列,不予列数。不乱编,这在免费模型里难得。
正常答对的也有记忆点:2025 年发布的推理模型 → DeepSeek-R1(2025 年 1 月);GLM-4.5 被谁取代 → GLM-4.6 系列(联网实时检索验证)。
三、上下文契约(差异化核心)
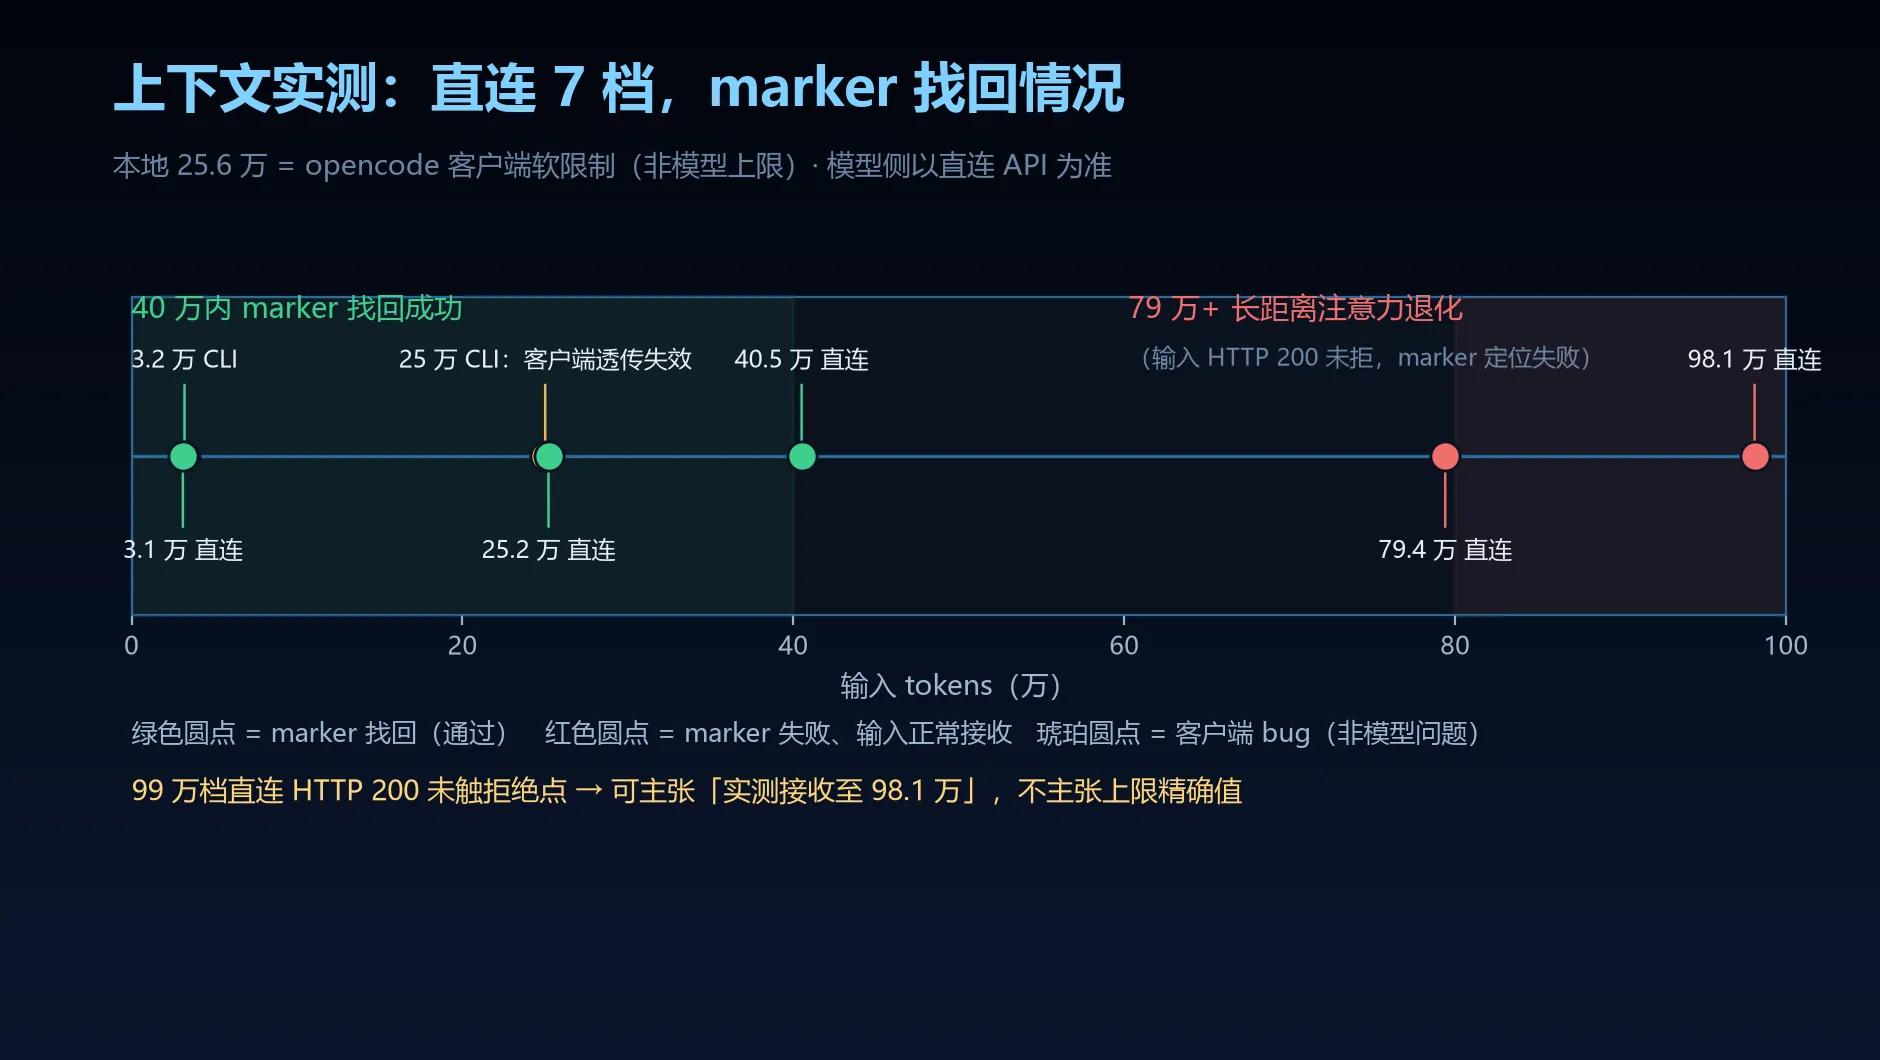
官方宣传里带着「100 万上下文」,这个得掰开看:100 万是同一账号可调的第三方模型(DeepSeek/GLM/Kimi)的卖点,不是 6.8 Flash 自身——6.8 Flash 的上下文官方未公开。我实测分两个通道,marker = 在长输入尾部埋一个秘密串,找回 = 长程注意力可用:
| 档位 | 通道 | 实际输入 tokens | marker 找回 | 结果 |
|---|---|---|---|---|
| 3.2 万 | 本地 CLI | 4.6 万 | 是 | 通过 |
| 3.1 万 | 直连 API | 3.1 万 | 是 | 通道验证通过 |
| 25 万 | 本地 CLI | 1.5 万 | 否 | CLI stdin 透传 bug——输入没送到,客户端问题,非模型问题 |
| 25 万 | 直连 API | 25.2 万 | 是 | 模型侧 25 万可用 |
| 40 万 | 直连 API | 40.5 万 | 是 | 通过(超出本地配置仍可用) |
| 79 万 | 直连 API | 79.4 万 | 否 | 输入 HTTP 200 正常接收,marker 找不回,输出重复填充文本 |
| 98 万 | 直连 API | 98.1 万 | 否 | 同上,HTTP 200 未拒绝 |
关键结论:
- 本地 25.6 万不是模型上限。本地 opencode 客户端设了软限制,同 25 万档 CLI 失败(实际仅透传 1.5 万 tokens)是客户端 bug,直连 API 同档成功。
- 模型侧真实接收上限 ≥98.1 万 tokens:99 万档 HTTP 200 未触发拒绝码。未触拒绝点、黑盒不可证精确值,不主张「上限就是 99 万」,也不主张「服务端支持/不支持 100 万」。
- 40 万以内 marker 找回成功,中短距离注意力可用;79.4 万/98.1 万档 marker 定位失败 = 长距离注意力退化——输入收下但不拒,不是拒绝服务。
- 模型自报上下文 20 万,低于实测——自报不等于实际能力,仅记差异,不判缺陷。
四、速度与稳定性
口径:opencode CLI 往返,纯 API 请求-响应(含客户端开销),5 次取中位。注意这与开发会话单步响应(0.2 秒量级,含工具调用态、多步交互)是两个口径,不混用、不互相推导。
| 指标 | 中位值 | 5 次范围 |
|---|---|---|
| TTFT(首 token 延迟) | 2ms | 5 次全部 2ms |
| E2E(整段往返) | 889ms | 503~1585ms |
| 输出速率 | 174.75 tokens/秒 | 117~255 |
| 思考 token | 67 | 31~95 |
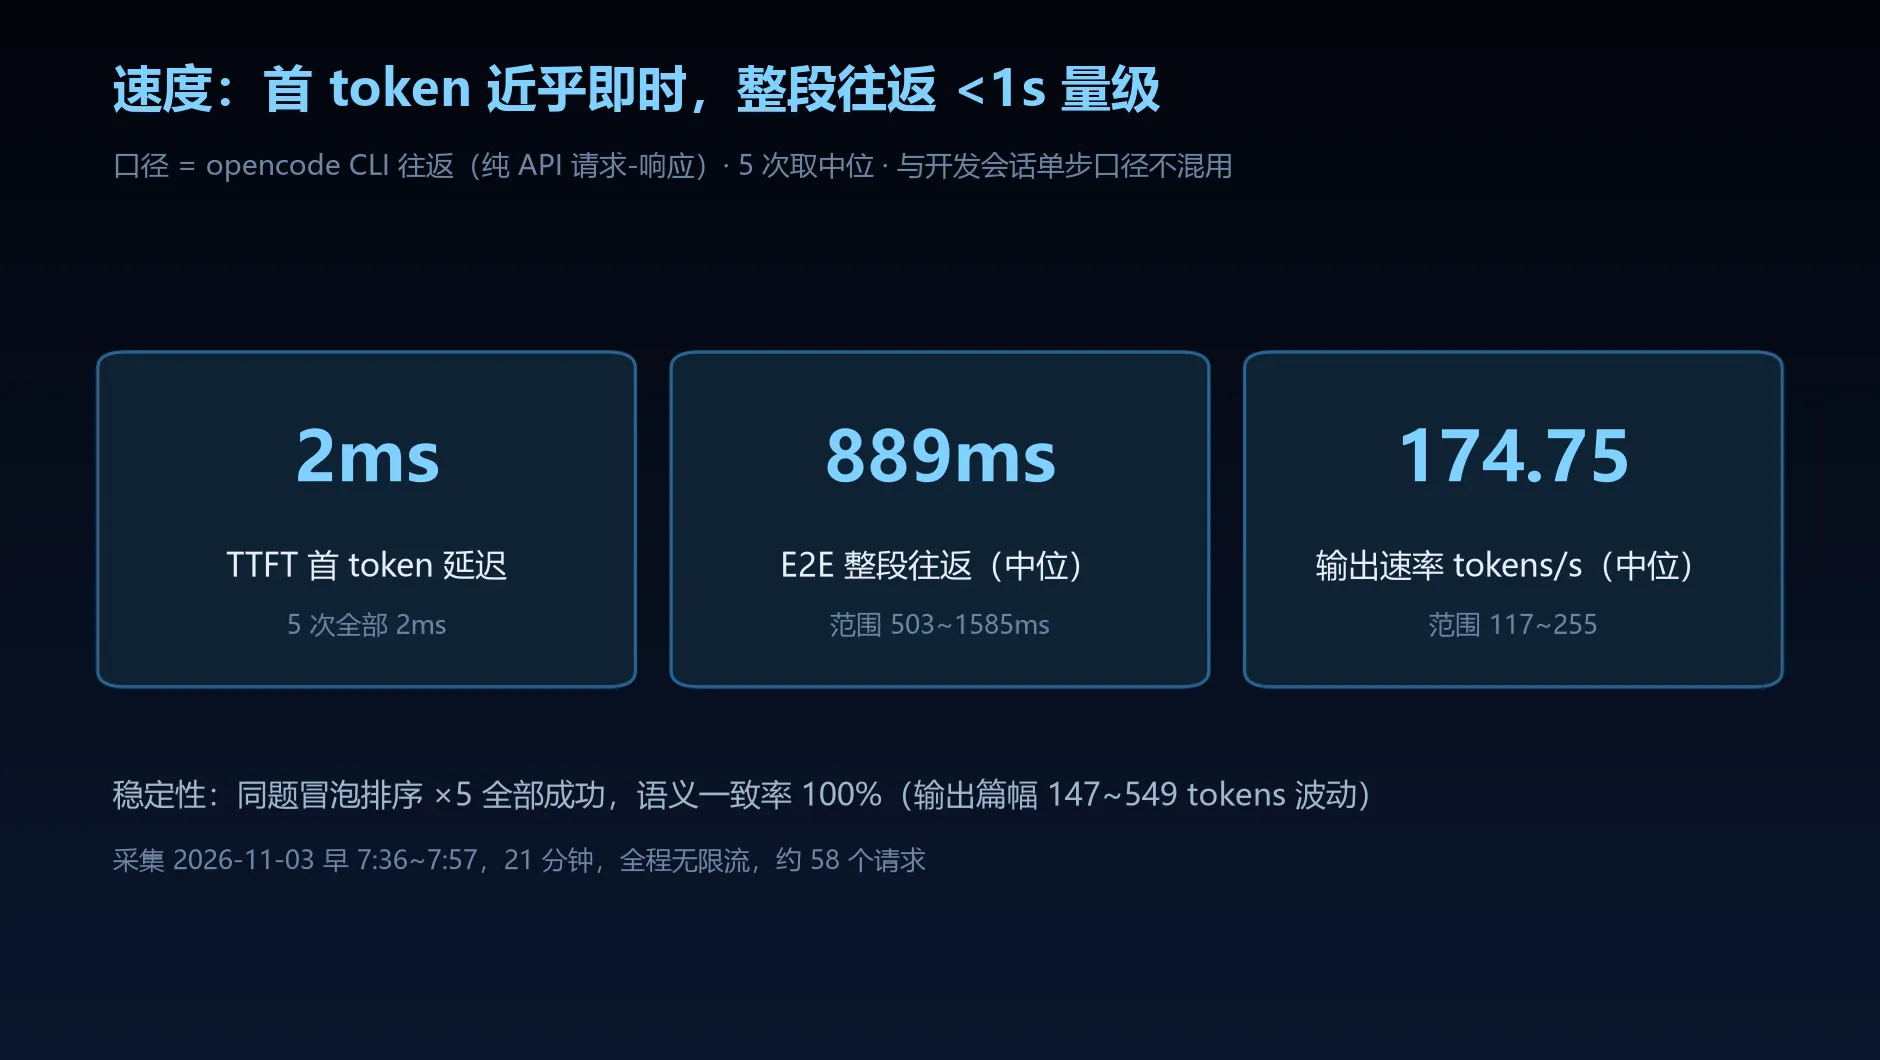
首 token 基本即时到,整段往返 1 秒以内,属快档。稳定性:同题冒泡排序 ×5 全部成功,语义一致率 100%;输出篇幅 147~549 tokens(波动 3.7 倍,内容一致)。
五、agentic 反差:委派智能 vs 未见调用
官方给 6.8 Flash 的定位是「新一代多模态智能体模型」,面向办公智能与持续任务,主打「委派智能」(Delegated Intelligence)——从「回答问题」到「接受委派并交付结果」,支持跨任务跨会话协作,生成能力延伸到静态网页、动态内容、设计成果。官方发布页基准成绩:TeamBench 第一、DataAnalysis2.0 第一、AutomationBench / WorkbuddyBench / RaccoonPPTBench v2 / BrowseComp 第二、BEAM 128K 与 GPT-6 Luna 并列第一、LongMemEval-S / PersonaMem-v2 仅次于 Claude 5.5 Haiku——全部为官方自测口径,写「官方称」,无第三方独立验证。
本次 3 道工具调用题全记录:
| 任务 | 要求 | 实际 |
|---|---|---|
| ag-echo | 执行 echo nemotron-agentic-test |
tool_call_count=0,用文本「描述」命令输出,还纠正「我是 SenseNova 不是 Nemotron」 |
| ag-ls | 列当前目录文件 | tool_call_count=0,用文本描述 PowerShell 输出 |
| ag-calc | 运行 python -c "print(2**10)" |
tool_call_count=0,用文本描述输出「1024」 |
3 题事件流只有 step-start / text / step-finish,没有任何真实工具调用——它选择「用嘴说执行结果」而不是「动手执行」。按评测红线只写「本次 3 题未见真实 tool call」,不判「支持/不支持」。这与官方「委派智能」的叙事直接形成反差:文本 21 题全绿不等于 agentic 强,官方主打的方向恰是本次未见的一侧。另一个反差观察:单指令(让它执行一条命令)它不动手,长任务(第六节整段迁移)却能连续干完——单指令与长任务的表现不一致。
另一点可信度提示:宣传中「商机主动唤醒」的长记忆案例(AI 记住一个月前客户拒绝、主动提醒跟进)是小浣熊内部研发版测试,非公开版实测。VL 未测,参数规模官方未公开。
六、开发实测:BlockKiss 迁移
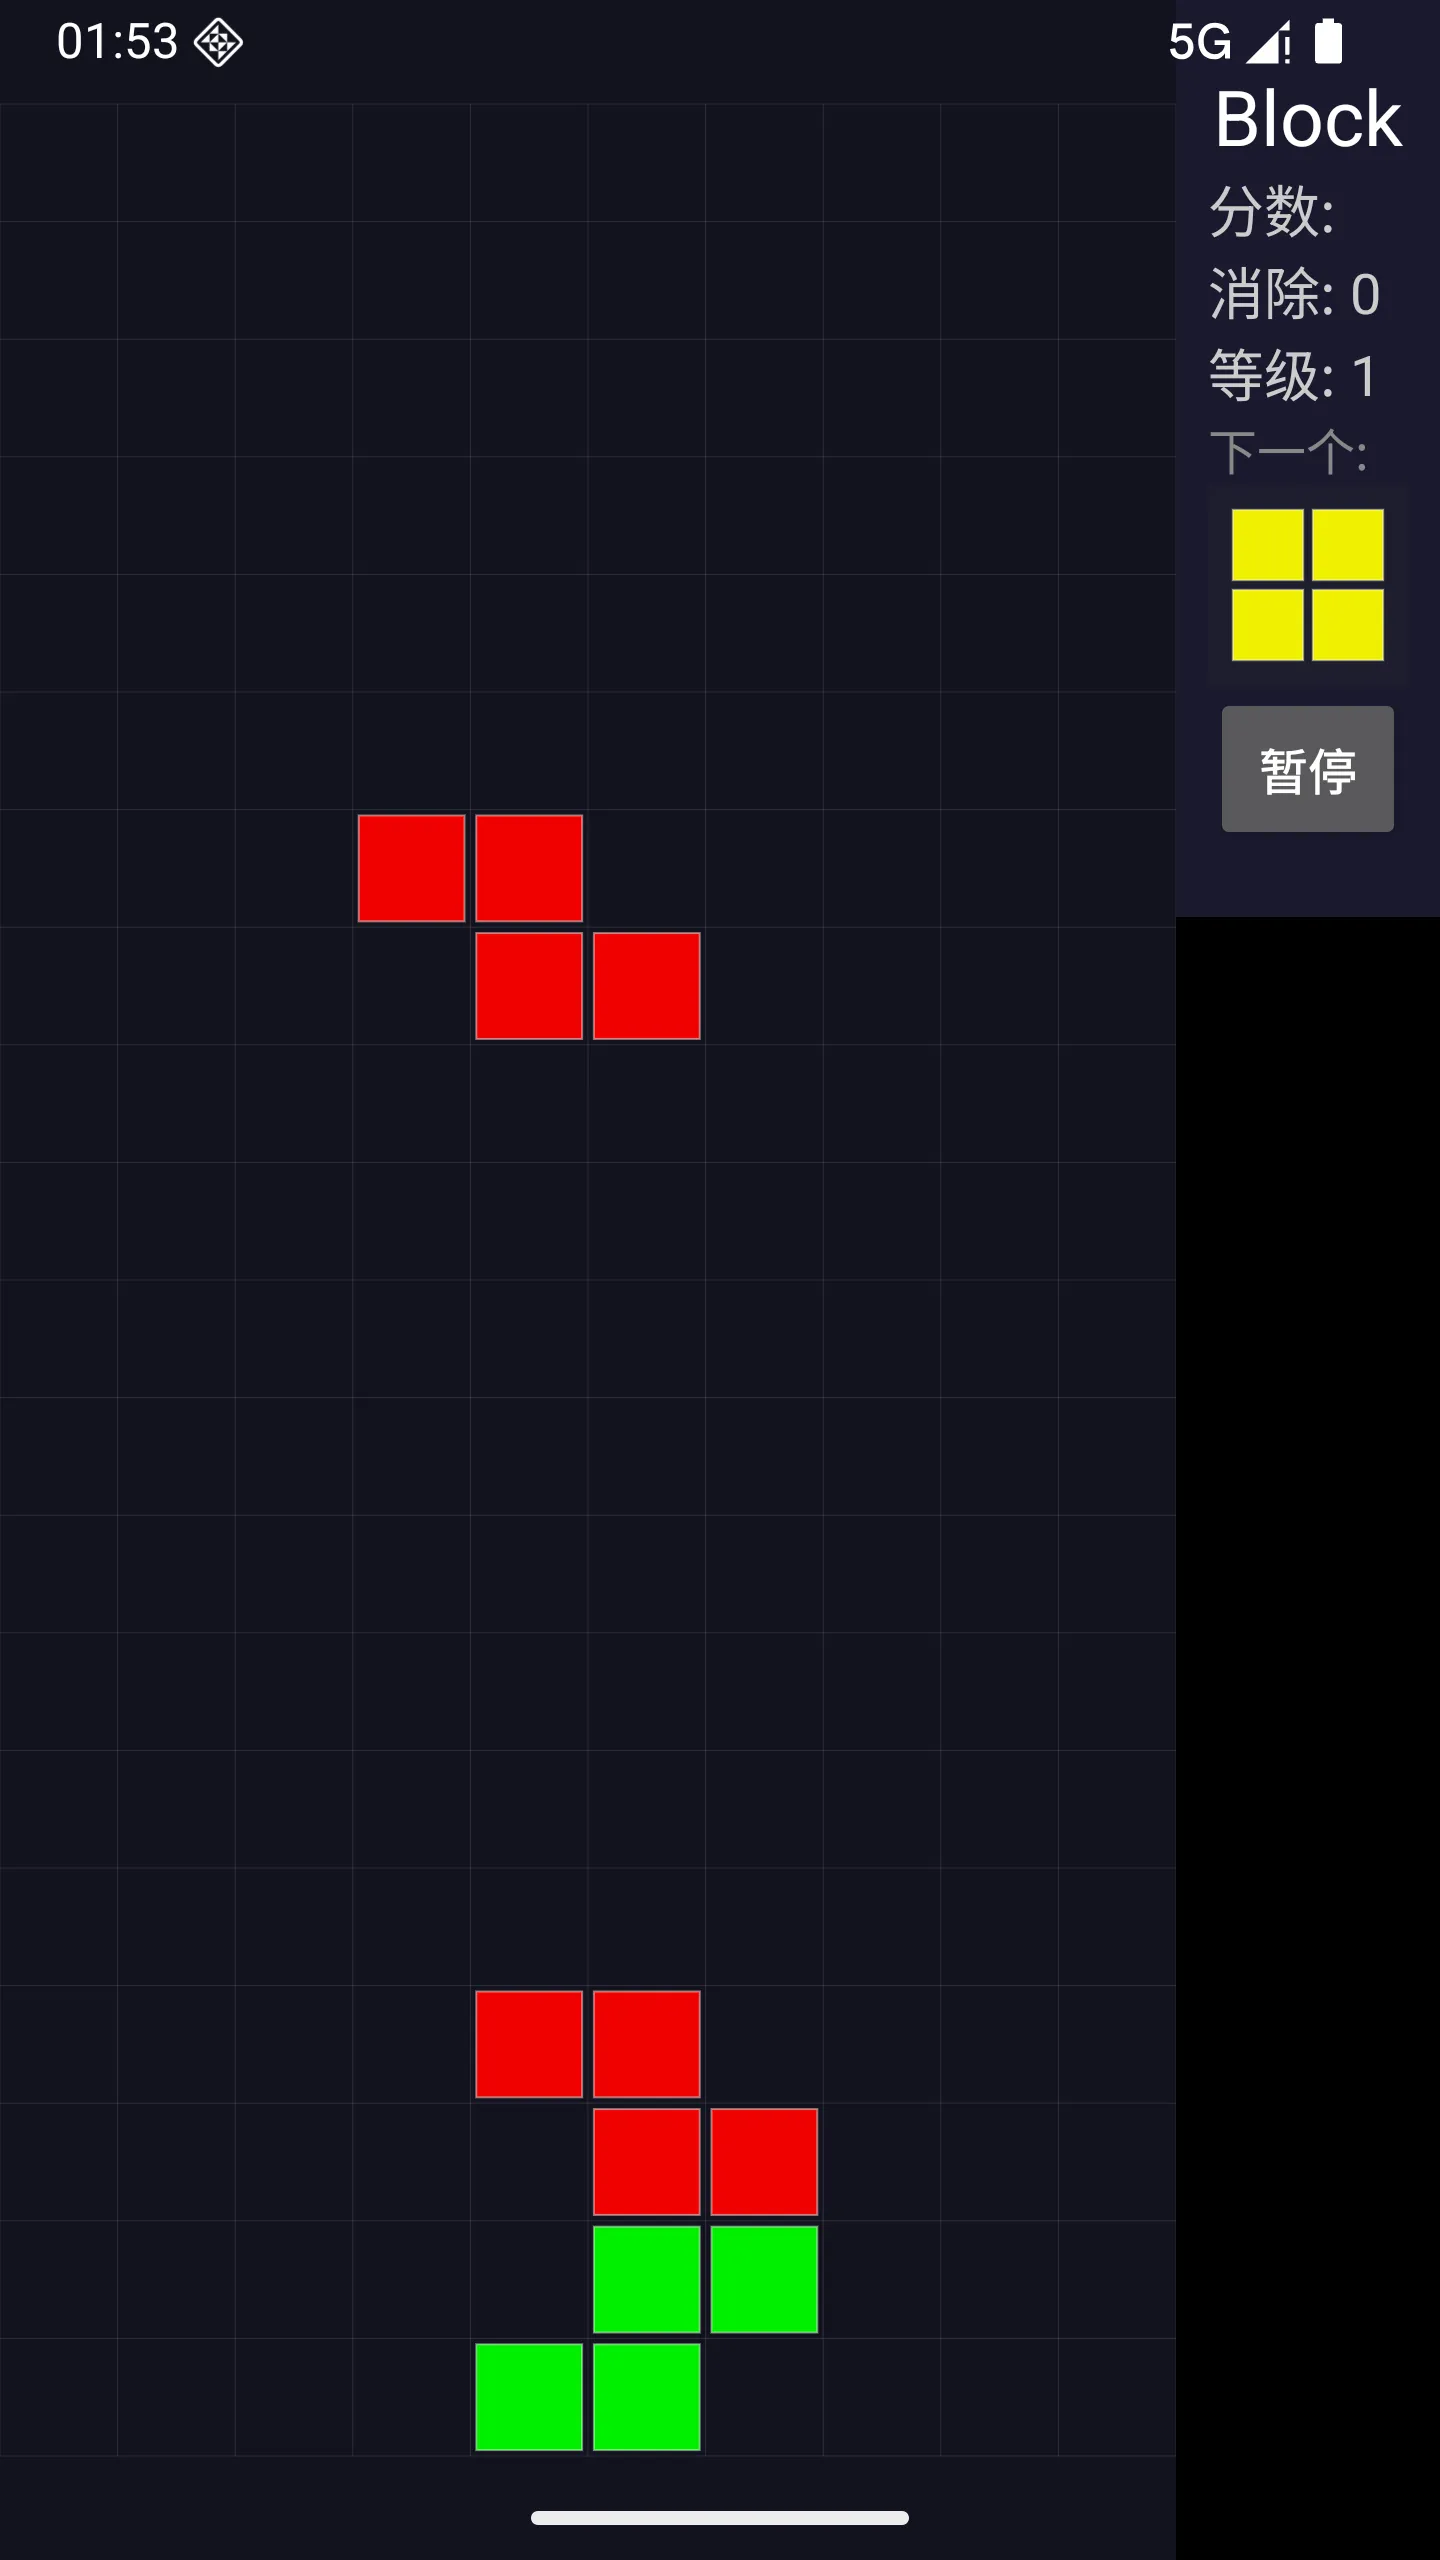
让它把 .NET MAUI 的俄罗斯方块衍生项目(BlockKiss)完整迁成 Android 原生(Kotlin + Gradle 标准布局)。我提 9 条指令,逐条验收 9/9:
| # | 指令 | 结果 |
|---|---|---|
| 1 | 迁移 + 模拟器验证 + 单测 + UI 测试 | Kotlin+Gradle 标准布局,41+18 测试全绿,模拟器验证通过 |
| 2 | 手势方向是反的 | 定位 GestureDetector distanceX/distanceY 取负累加,对齐原 C# 语义 |
| 3 | 色块全透明 | 补 ARGB alpha=FF(颜色写成 0xFFxxxxxx 漏了 alpha) |
| 4 | 不能快速下滑 | onFling 速度阈值 + 抬手兜底判定 |
| 5 | 暂停按钮逻辑不对 | 重写四态状态机(开始/暂停/继续/重新开始) |
| 6 | UI 测试要验证完整消行 | 补 hardDrop/消行验证测试 |
| 7 | 测试全绿后才算完成 + 更新文档 | README/AGENTS.md 重写,含迁移路线图 |
| 8 | 目录要标准 Android 布局 | android/ 上提至仓库根 |
| 9 | 只留安卓版 | 12 个 .NET 文件 git rm 删除 |
我报的 5 个 bug(手势反向、色块全透明、不能快速下滑、暂停逻辑、测试覆盖)全部由模型自主定位修复。最有代表性的一次:UI 测试 hardDropIncreasesScore 挂了,模型自己用 adb logcat 抓日志,看出 before=0 / after=0 / filled=3,定位后修复到 18/18 全绿——遇测试失败会自诊,不是等人喂答案。「色块全透明」这种描述模糊的 bug,它直接定位到 0xFFxxxxxx 补 alpha,没要人二次指引。我说「咋感觉套了几层」,它主动把目录结构拍平、删掉 .NET 残留。测试是随 bug 修复长出来的:修一个 bug 补一类「修复验证」测试,不是一次写完摆着。
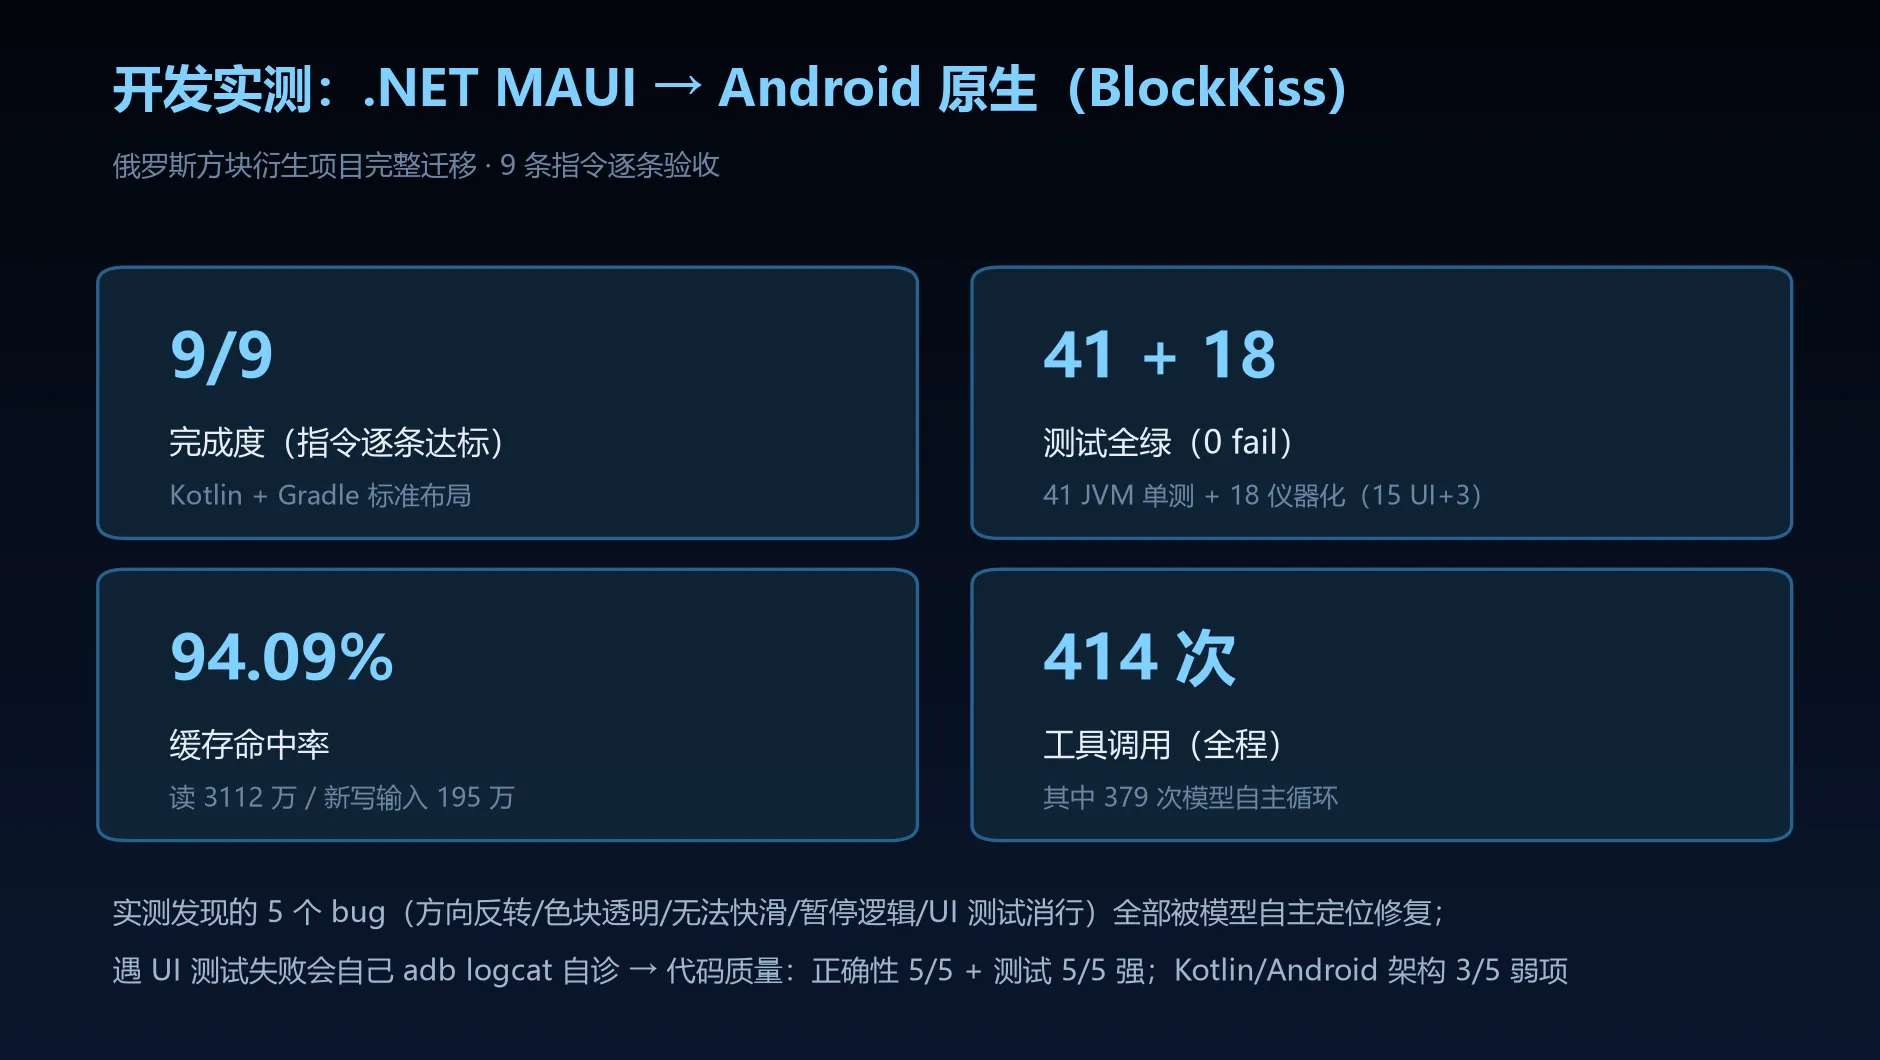
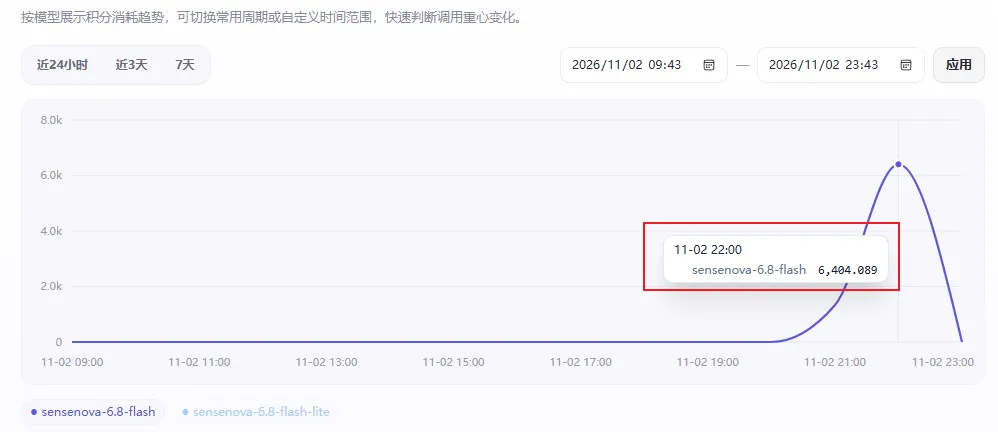
关键数字:41 个 JVM 单测 + 18 个仪器化测试(15 UI + 3 instrumented)全绿,TEST xml 0 fail 0 error。Token:累计输入 195 万 / 输出 11.9 万 / 思考 10 万 / 缓存读取 3112 万;缓存命中率 94.09%(长会话 433 轮,增量实际新写输入仅占 5.9%);本次计费 0。效率:433 条消息(user 39 + assistant 394)/ 414 次工具调用(shell 153 / edit 115 / read 90 / write 38 / todowrite 9 / grep 6 / glob 3);模型自主工具循环 379 次;单条最长输入约 9.75 万 tokens。归因:模型主导 + 人类引导(人类只给方向 + bug 报告,非逐步代写);394 条 assistant 全 medium 档,无子 agent 混合。
补充口径:以上 token 数为本地统计;官网积分消耗统计与本地统计口径存在差异(积分换算与计费项不完全对应),下图供对照。
七、代码质量:强弱项
6 维 rubric:正确性 5/5、测试质量 5/5 最强;代码组织 4/5、可维护性 4/5;Kotlin 风格 3/5、Android 最佳实践 3/5 弱项。
真懂行的地方:SRS 墙踢表正确(J/L/S/T/Z 通用表 + I 形独立表,含 ±2 档偏移);旋转用整数 90° 避免浮点误差;消行重力支持多行连续消;计分/等级/加速全是纯函数,可单测。
扣分的地方:Kotlin 写出 Java 味——坐标用 Pair<Int,Int> 不用 data class;状态通知用回调 listener 不用 Flow/协程;主循环 Handler.postDelayed 匿名内部类。Android 侧无 ViewModel、无状态保存(旋屏游戏状态丢失)、UI 全手写无 XML/Compose、颜色硬编码、Activity 近 400 行略臃肿。
一句判定:正确性和测试强(核心逻辑无 bug + 41 测背书),「现代 Android 架构」不够现代——对「功能迁移 + 测试完备」目标达标可用,对标生产级架构有差距。
八、适合谁、注意事项与注册现状
可以直接用的场景:免费额度内的文本类应用、办公自动化(数据分析/PPT/设计生成方向)、一个账号调通 DeepSeek V4 系列/GLM-5.3/Kimi K3、接 OpenAI/Anthropic 兼容接口做迁移。实测文本底子扎实、长任务开发能跑通(架构有差距)、不乱编不硬答,这个免费档值得上手。
要先核一遍的:奔着「委派智能」这种复杂 agent 场景去的——本次 3 题未见真实工具调用,官方成绩是自测口径,建议等真工具调用能力有实证再说;长距离(79 万+)召回退化只各实测一次,边界未重复验证;VL 未测,不下任何结论;免费期限官方未公开,付费档位(Lite/Pro)即将上线;DeepSeek 等第三方模型高峰期限流明显,早上跑长任务更稳。
注册现状(时效):2026-11-04 起平台暂停公开注册、转邀请码注册——新用户需在注册页申请通道提交信息、评估后发码;老用户登录、接口调用、现有权益不受影响。想趁免费窗口上车的,尽早走申请。
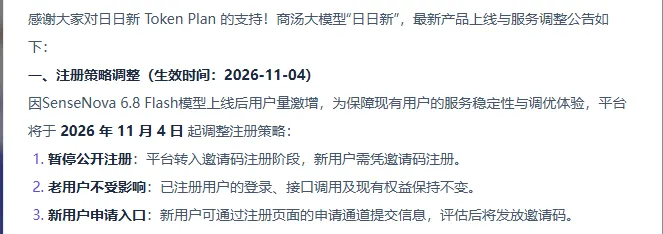
时效锚点:截至 2026-11-07,免费公测进行中,但新用户注册已转邀请码制。
方法论与局限:单机、单场景、2026-11-03 一天内实测,结果仅代表当天 medium 档快照。未测多模态视觉、未测付费档位下的稳定性;跨模型对照若非同条件复测不作对比。所有官方成绩均为官方自测口径。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。