NVIDIA Nemotron-3.5-Super-VL-Free 免费端点实测:开发真工具只花 2 小时、看图 4/4、94 万上下文(2026-10)

先说能不能用:NVIDIA 的 Nemotron-3.5-Super-VL-Free 是 opencode 免费货架 10 月 15 号新上的视觉语言(多模态)推理模型,它支持文本 + 图像理解,能看图、能开发、还能塞超大上下文。我拿它干了一件真事——从 0 到 1 开发一个 WPF 图像处理工具(ONNX Mask 生成),全程 10.29 小时,但模型真正在干活的时间只有 1.98 小时:这 10 小时里有 7.62 小时是异常(UI 测试挂起 5.08h + 最后撞配额上限停掉 2.54h),只有 0.65 小时是 build 之类有效工具执行——这些都不能算在模型能力头上。基础能力按 low 深度跑了一遍,推理/代码/中文/结构化都达标(事实题 4/5,小样本里错了一道年份);多模态看图 4/4 全过;上下文实测塞到约 94.1 万 tokens 还能答对,990K 才被端点拒绝。这是一个「免费、能看图、能开发、长会话耐力强」的工程型模型,日常编码和文档任务可以直接用;但它有明确的使用边界(NVIDIA trial 条款),下面逐条说。
一、这次测的对象与配置
这次测的是 opencode 免费端点上的 nemotron-3.5-super-vl-free,对应 NVIDIA 的规范模型名 nvidia/nemotron-3.5-super-vl-120b-a12b,开源权重,2026 年 10 月 15 号发布。名字拆开看:Super = 旗舰级,VL = 视觉语言(Vision-Language),120B A12B = 总参数 1200 亿、激活参数 120 亿的稀疏 MoE。
| 项 | 值 |
|---|---|
| 被测端点 | opencode/nemotron-3.5-super-vl-free(NVIDIA trial 免费端点,$0/$0) |
| 规范模型 | nvidia/nemotron-3.5-super-vl-120b-a12b(开源权重) |
| 类型 | 视觉语言推理模型(文本 / 图像理解) |
| 上下文声明 | models.dev 标 1,048,576(100 万);本次实测至约 94.1 万成功、990K 拒绝,100 万未完全实测 |
| 思考档位 | 开发用 medium,基础能力用 low |
| 发布 | 2026-10-15 |
免费端点数据条款(NVIDIA trial):仅限试用,日志由 NVIDIA 留档(安全/改进用途),勿提交个人/机密数据。本次评测全程用公开/合成数据。
二、实测一:真实开发——模型干活不到 2 小时,做完一个完整工具
这是我最想说的部分。我用它从 0 到 1 开发了一个真实的 WPF 图像工具(Link.SoloMedia.Studio:ONNX Mask 图像生成,.NET 10 + MVVM + U-2-Net 推理),全程 270 步长会话,整个开发过程产出了 15 个源文件,代码全部由模型产出,我只注入需求和验收标准(16 条用户消息,集中在后半段)。
完成度:能跑,单测全绿
| 模块 | 状态 |
|---|---|
| WPF 工程(App / 单测 / UI 测试三工程) | ✅ 可编译可运行(build 0 错 0 警) |
| UI(选图 / 生成 Mask / 保存 / 双图预览,MVVM) | ✅ 完成 |
| ONNX U-2-Net 推理 + 无模型回退算法 | ✅ 完成(真机推理链路未在会话内验真) |
| 单元测试 | ✅ 6/6 全绿(126ms) |
| UI 自动测试 | ⚠️ 1/2(主流程用例红,FlaUI 环境/断言问题,非代码 bug) |
| git 提交 | ❌ 会话被配额打断,收尾未做 |
代码完成度约 90%,验收完成度约 70%。270 步里模型只报了 3 次错需要反复(0.3 步/千 token 量级),工程素养在线:建了 MVVM 分层、依赖注入、异步 + 取消令牌、单测工程、模型自动下载(多镜像容错);踩坑自愈——PowerShell 中文乱码换惯用法绕开、.NET 目标框架不匹配(NU1201)自己修。
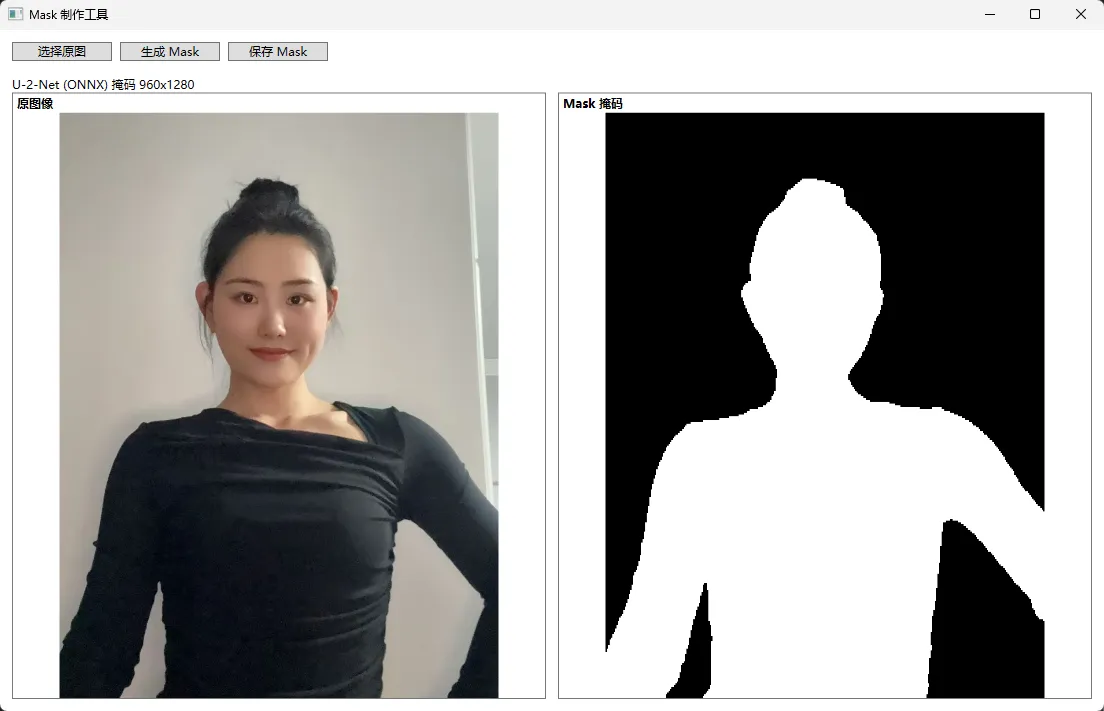
这是最后跑起来的主界面:左边选原图、右边出 Mask,双图预览 + 保存按钮都在:
时间账:总耗时 ≠ 模型能力
总耗时 10.29 小时,模型真正在干活只有 1.98 小时(19%)。 但整个会话的有效干活时间不止这些,拆开来是两类:
- 干活时间 2.63h(26%):
- 模型干活 1.98h(19%) = 推理思考 0.92h + 响应生成/调用开销 1.07h。这是「步骤时长 − 工具时长」的口径,中间的网络重试、调用排队这类通信开销都算在这条线里面了——只多不少。
- 其余工具 0.65h(6%) = dotnet build / 包管理 / 文件系统排查——这些是有效的开发动作(不白干),但属于工具执行,不算「模型在干活」。
- 异常情况耗时 7.62h(74%):
- FlaUI UI 自动化测试挂起 5.08h(49%)——
dotnet test驱动 WPF 调试弹窗时 UIA 找不到元素,测试进程空转,纯环境问题。 - 配额停掉 2.54h(25%)——会话收尾时撞上免费端点每日配额上限,从 04:03 起模型完全不再响应,空等到 06:36(无产出)。这是最后真正到限流停掉的,不算干活时间;归为免费端点的调用限制。
- FlaUI UI 自动化测试挂起 5.08h(49%)——
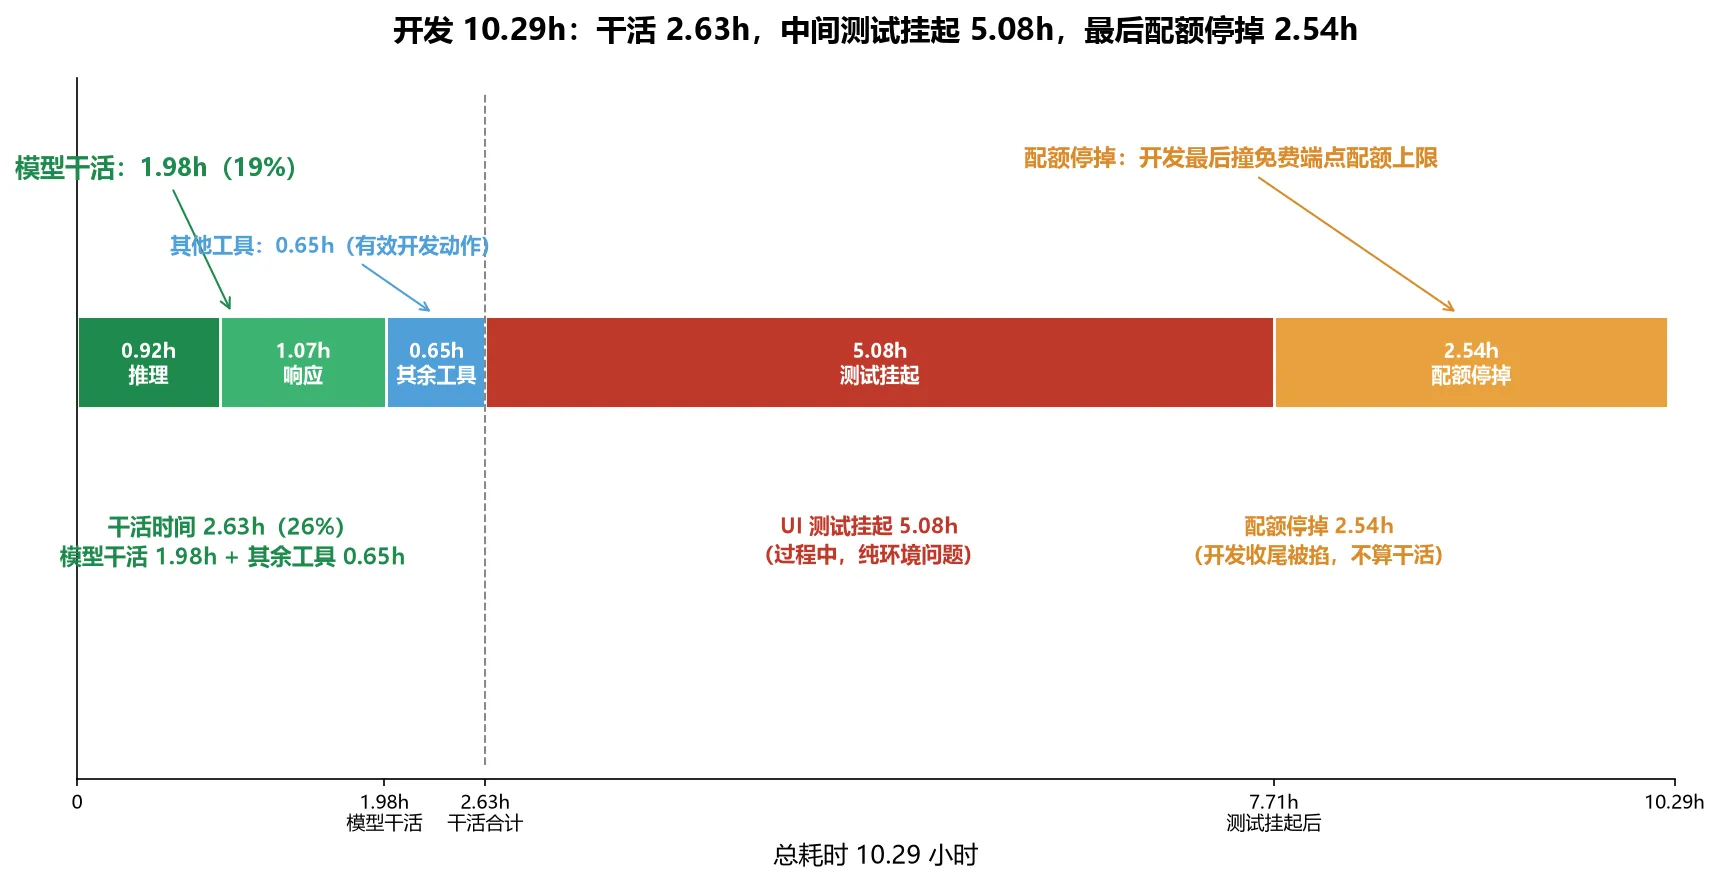
所以别拿 10.29 小时这个数去判断模型快慢——真正算模型在干活的时间只有 1.98 小时;就算把工具执行里有效的 0.65h 也算进「干活」,总共 2.63h(26%),剩下的 7.62h(74%)全是异常(测试挂起 + 配额停掉),跟模型能力没关系。
token 账:约 3388 万,$0
整段开发共消耗约 3388 万 tokens,明细如下:
| 口径 | Tokens | 单步均值 |
|---|---|---|
| 输入(非缓存) | 约 122 万 | 约 4,505 |
| 输出 | 9.1 万 | 337 |
| 推理 | 13 万 | 481 |
| 缓存读 | 约 3240 万(占 95.8%,命中率 96.4%) | — |
| 合计 | 约 3388 万 | — |
| 成本 | $0(免费端点) | — |
缓存读是绝对大头——典型 agentic coding 特征:上下文高度复用,模型每次请求重放历史,只为新增量付少量输入。输出非常克制(单步平均 337 tokens,多为工具调用参数而非长篇文本)。
模型耗时账:单步响应中位 3.4 秒,270 步只错 3 次
| 口径 | 值 |
|---|---|
| 单步推理时长 | 中位 3.4s / 均值 12.2s(均值被少量深思考步拉高) |
| 单步模型总耗时(含生成) | 中位 10.6s / p90 75.1s |
| 报错需反复 | 270 步仅 3 次(0.3 步/千 token 量级) |
| 质量滑坡 | 未见(10.29h / 270 步长会话) |
| 中断原因 | 配额上限(最后一步无产出),非上下文退化 |
结论:medium 深度下它属于「轻思考、快产出、长会话耐力强」的工程型模型——模型单步响应很短,token 消耗主要来自上下文重放(缓存命中下免费端 $0),真正的费用/时间大头都不在模型本身。
三、实测二:基础能力——低档达标,事实小样本含错
按 low 深度跑基础能力剖面:
| 维度 | 结果 |
|---|---|
| 推理 | 3/3(水箱题 / 逻辑包含 / 因式分解) |
| 事实 | 4/5(1 错:一道年份题答「2002 年」,预期不符——小样本,含错,如实标注) |
| 结构化 | 3/3(JSON 输出合法) |
| 选择题 | 5/5 首词正确 |
| 中文 | 流畅贴合语境(秋天短文) |
| 代码 | 3/3(fib / avg / HTML 骨架,语法正确) |
速度(low,5 次取中位数):TTFT 2.67 秒、端到端 E2E 4.67 秒、输出速度 74.9 t/s、思考 tokens 242。稳定性:同题跑 5 次,唯一输出 5/5 一致(代码输出仅注释微差)。
调用成功率:有失败记录,但都不是端点稳定性问题
干活过程中最关心的其实是“这免费端点稳不稳”。把当天所有请求数了一遍:
| 模块 | 成功 | 失败 | 失败归类 |
|---|---|---|---|
| 能力剖面 + 对照 | 40/40 | 0 | — |
| 身份自报 | 6/6 | 0 | — |
| 速度(5 次) | 5/5 | 0 | — |
| 多模态 VL | 4/4 | 4 次 | 评测姿势坑(prompt 被当文件路径),修复后重跑全成 |
| 上下文 32K→800K | 4/4 | 4 次 | 990K 边界拒绝(预期行为,非干活调用失败) |
模型/端点本身没有稳定性失败——能力、身份、速度这些标准请求共 51 次全成功,没有 5xx、没有超时、没有限流导致的拿不到结果。但中间确实有 8 次失败调用,只是都能归到非模型/非端点的问题上:VL 初跑 4 次是评测脚本把提示词当文件路径(姿势坑,修复后 4/4 全成),990K 4 次是上下文边界拒绝(模型说“再往上是它的极限了”,预期行为)。
四、本次实测验证:多模态 4/4 + 超长上下文 ≥800K
这是本次评测补上的一个新维度:之前测 DeepSeek V4.1 Flash Free、GLM-5.3-Flash-Free 时,它们其实也支持图像输入,只是当时聚焦文本上下文契约、没跑多模态。这次 Nemotron 专门拿图实测了多模态。
多模态 VL:看图 4/4 全过
拿一张公开非敏感人像照片测了四类:
| 题 | 结果 |
|---|---|
| 描述内容 | 正常:东亚女性、黑发高发髻、黑色单肩、素色墙面、光线柔和 ✅ |
| 细节 | 正常:丸子头、淡粉口红、单肩露肩设计、衣物褶皱 ✅ |
| OCR(有无文字) | 「没有文字。」✅ 准确判空 |
| 场景 | 室内/工作室素色墙前拍摄 + 理由链(背景极简/光线均匀/构图刻意)✅ 带推理 |
text+image 输入 4/4 正常理解——多模态是真实能力,不是摆设。
超长上下文:32K→800K 全成,990K 拒绝
用超长文档检索法(伪随机填充 + 尾段藏秘密词,要求模型只输出秘密词)实测:
| 档位 | 实际输入 tokens | 结果 |
|---|---|---|
| 32K | 约 5.9 万 | ✅ 秘密词找回 |
| 250K | 约 30.5 万 | ✅ |
| 400K | 约 47.4 万 | ✅ |
| 800K | 约 94.1 万 | ✅ |
| 990K | — | ❌ 拒绝(Bad Request 400,重试全拒) |
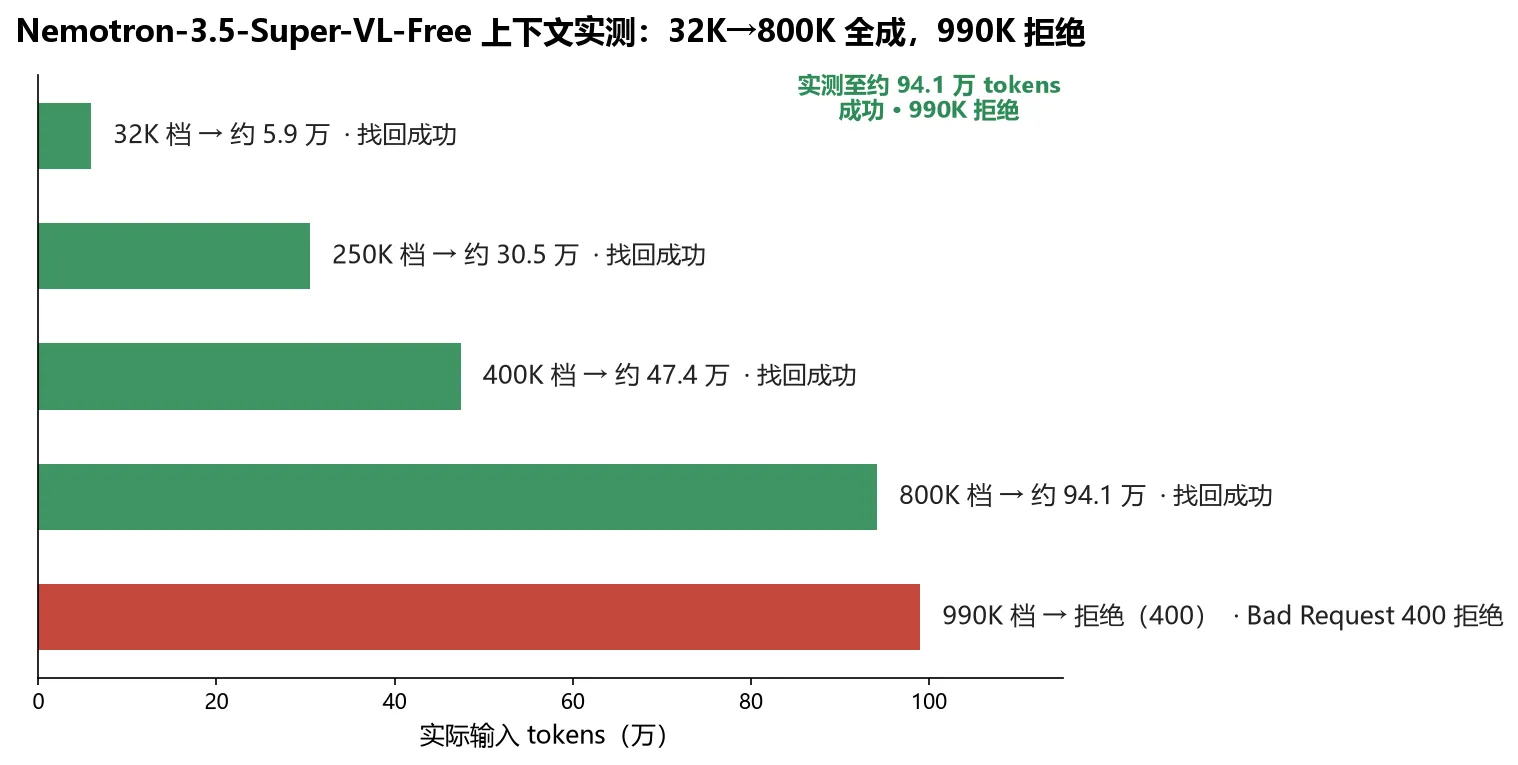
实测可处理到约 94.1 万 tokens 输入,990K 才被端点拒绝。这个量级不低(比很多模型能装的都多)。models.dev 标的 100 万属于「接近但未完全实测」——我测到约 94 万就成功了、990K 被拒,不敢说上限就是 100 万。
五、注意点
- 契约差异(记录不判死):模型自报上下文 128K,与 models.dev 声明 100 万不符;自报「不支持思考档位」,但端点实际接受 low/high 档(对档位不敏感/忽略)。
- NVIDIA trial 条款:免费端点仅限试用,日志由 NVIDIA 留档(安全/改进用途),勿提交个人/机密数据——用它跑业务敏感数据要谨慎。
- 免费限制:配额有上限,重负荷会撞墙:opencode 免费端点有每日配额上限(约 200 次请求 / 天,UTC 重置),这是当天实测中真实碰到过的:开发会话(medium,270 步)收尾时被配额上限打断过——最后一步模型无响应 2.54 小时(就是时间账里算进模型侧那 2.54h)。所以连续重负荷跑活时,要留意配额、错峰使用;这是免费端点的调用限制,不是模型推理能力的问题。
- 另注意:990K 拒绝是上下文边界(服务端 Bad Request 400,isRetryable=false),不是限流;评测期间还遇到过本机调度侧的限流抖动,那是评测环境问题,不是被测端点。
六、结论与适用场景
一句话:免费、能看图、能开发、长会话耐力强——这是 opencode 免费货架上目前最有「生产力」质感的多模态模型(截至 2026-10-19 实测)。
- 日常编码、文档任务:直接开用。开发实测证明它能从 0→1 干真项目,270 步长会话不滑坡,medium 档单步响应快、token 用量结构省(单步输出均值 337)。
- 多模态场景(看图/OCR/场景判断):可以用。4/4 全过,识别准确带推理。
- 大上下文任务:80 万 tokens 以内实测稳,990K 会被拒——长文档检索别超过约 94 万这个实测线。免费端缓存命中率高(96.4%),大上下文重放成本低。
- 要先想清楚的:NVIDIA trial 条款(日志留档,别传机密数据);事实题小样本含错(重要事实建议交叉验证);免费配额约 200 次请求/天上限,重负荷会撞墙(开发收尾被卡住 2.54h 就是撞墙现场),记得错峰。
- 时效提醒:免费端点限时免费、配额有上限(重负荷使用需错峰),配置随时可能调整;结论只对 2026-10-19 当天的实测有效。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。