MiniMax M3.1 Flash 开发能力实测:真项目加了个生图功能,完成度 100%
国内 AI 厂商 MiniMax 稀宇科技的 M3.1 Flash,是 M3 系列的轻快档推理模型,主打 1M 大上下文 + 51.2 万输出。2026 年 10 月它在 opencode 上线了免费档,我趁那会儿把它拉去做了个深度实测——主线不是跑指标,是拿它在我现有的工具上加了个功能:在一个 Mask 抠图工具上加百炼 wanx 生图全链路,几十个文件、五千多行,编译 0 错、单元测试全过、真实接口端到端出图,完成度 100%。顺带验证了它基础不差:1M 上下文实测顶到 95.4 万 tokens 一路成功、单步响应中位 0.2 秒、agent 工具调用 3/3。
它不光是“能聊能答”,是能实打实干完一个真项目开发的模型——1M 大窗口 + 单步 0.2 秒快响应,这个组合不多见。
先交代下:当时那个 opencode 免费档现在已经下线了;如果还想免费试用,可以调 NVIDIA 那个 minimaxai/minimax-m3.1-flash。上面的结论都是依据 2026-10-20/21 的 opencode 免费端点实测得出的。
一、值不值得用
它的真本事不在跑分,在能真干活:既有工具上加新功能、项目重命名全量同步、踩坑自愈(ONNX 相对路径 bug)、长会话(将近两个半小时、五百多步)不滑坡——这些是开发场景真实需要的。真拿它做开发,0.2 秒单步 + 缓存复用让长会话很舒服,顺带还能处理大上下文场景(塞长代码库、长文档)。
怎么试同款:走上面说的 NVIDIA 免费渠道即可;MiniMax 官方付费档价格是 $0.15/$0.60。
要留意的:
- 结构化输出契约不支持,要严格 JSON 的任务得掂量;
- 我只测了文本维度,多模态没测;
- 这次实测就一台机器、一个场景,10 月 20、21 日这两天,结论都是依据当时的 opencode 免费端点得出的;NVIDIA 平台的能力/软限可能不同,别把 opencode 免费端的实测数据直接套到 NVIDIA 上。
二、给现有工具加了个 wanx 生图功能
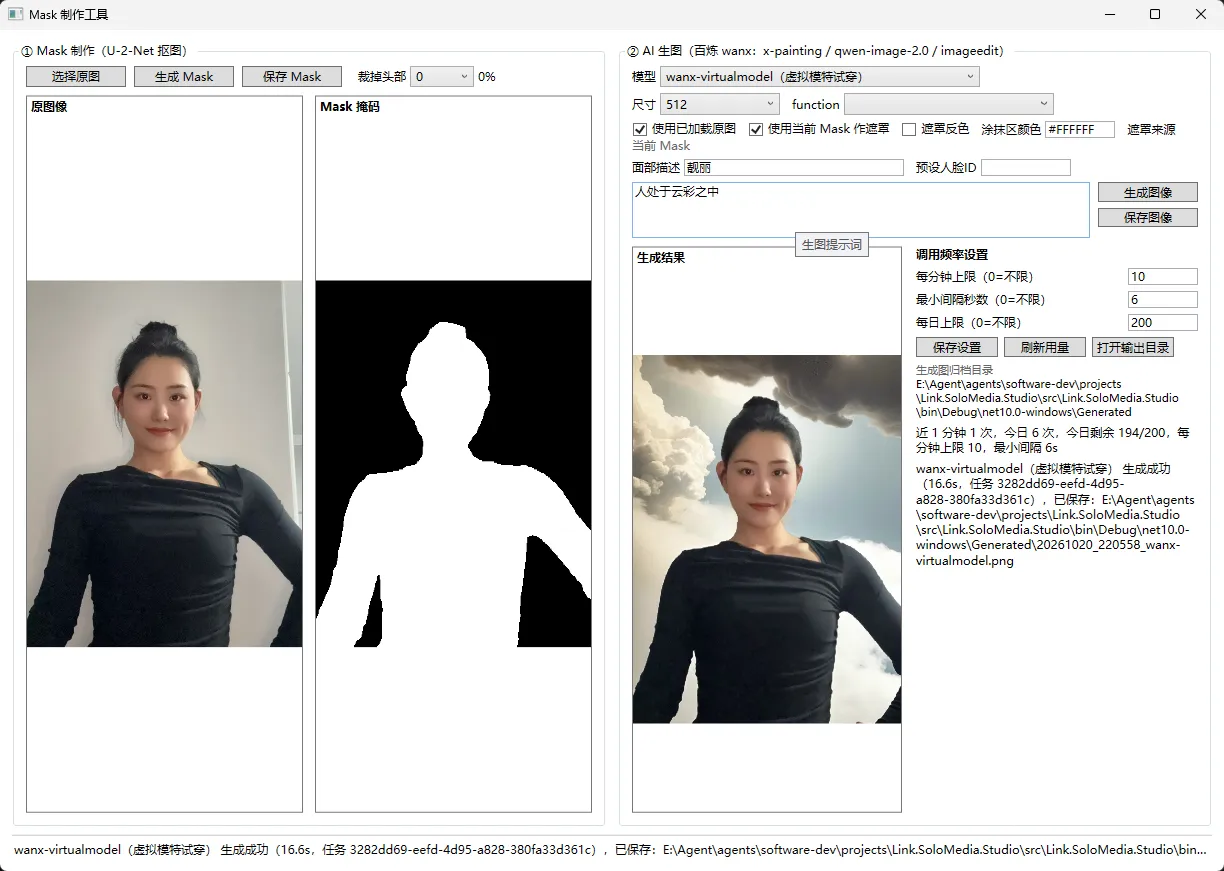
我把它放到真实项目上,添加了个新功能——在我现有的一个 Mask 抠图工具上加百炼 wanx 四模型生图全链路(mask→生成图),顺带做项目重命名、修掉一个 ONNX 相对路径 bug。
交付体量:几十个文件、五千多行,全程模型独立产出,我只注入需求和审阅点(20 条消息,逐步 diff 确认)。
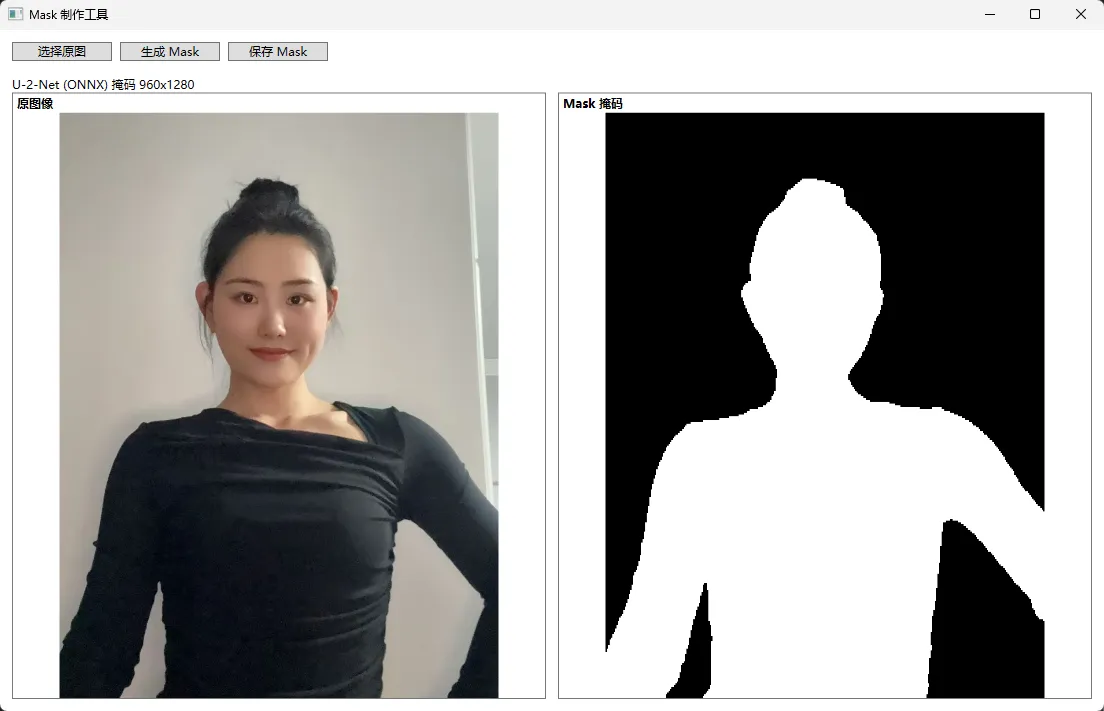
先看界面变化——第一张是原有的 Mask 抠图工具(前版本),第二张是模型帮我加上百炼 wanx 生图功能后的样子(新增了生图区)。
前版本 Mask 抠图工具界面:
新增 wanx 生图功能后的界面:
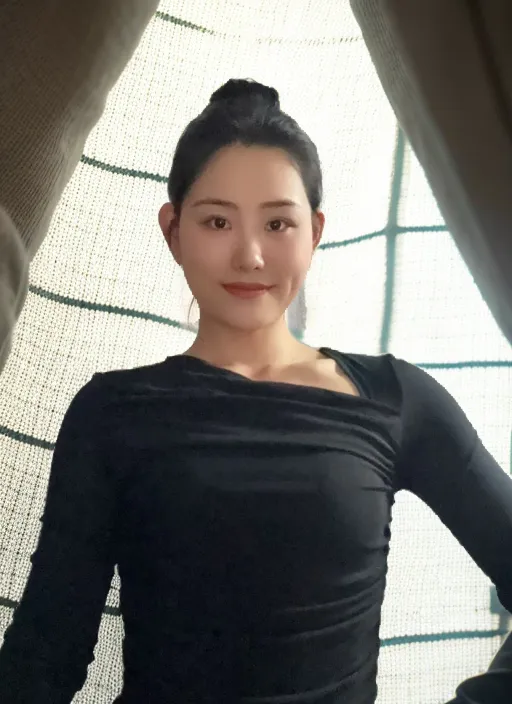
而且不是只把界面画出来,是真实把整条链路跑通了——抠图→上传→百炼 wanx 生图,真出了图(下图是实际生成结果,520KB)。
真实端到端出图结果:
验收每一项都绿:
| 验收项 | 结果 |
|---|---|
| 编译 | 0 错误 |
| 单元测试 | 全过 |
| 真实端到端(百炼接口) | 抠图→上传→wanx 生图实测出图成功 |
| 交付 | 全部提交、工作树干净 |
我提的需求它都落到了实处:项目重命名全量同步(命名空间、工程文件、exe 定位、测试入口一处不漏)、模型清单做成配置驱动(可自行增删)、调用频率控制(每分钟/每日上限,跨重启仍限流)、日志分层、网络重试下沉到传输层、遮罩语义按不同模型分别处理、测试做了分层(单元测试→UI→真实接口)。另外它自己定位并修了一个 ONNX 相对路径 bug(File.Exists 按当前工作目录解析导致 UI 自动化静默回退),改绝对路径 + 加防退化断言——这种“踩坑自愈”的能力,说明它是真在干活,不是照着模板填空。
时间上,整个会话跑了将近两个半小时,但真正模型干活只有二十来分钟(不到 20%)——大头是编译一个来小时、和我交互确认大概占用一个小时,这两块都不占模型时间,模型本身单步很快。
三、开发这块够了,基础再验一遍
开发这块已经够了,基础能力我再进一步验证一遍,看看是否同样稳。
能力剖面全绿:推理、事实、中文、近两年新信息、可运行代码全通过。
| 维度 | 通过 |
|---|---|
| 推理 | 3/3 |
| 事实 | 5/5 |
| 中文 | 2/2 |
| 近两年新信息(dated_facts) | 8/8 |
| 可运行代码 | 3/3 |
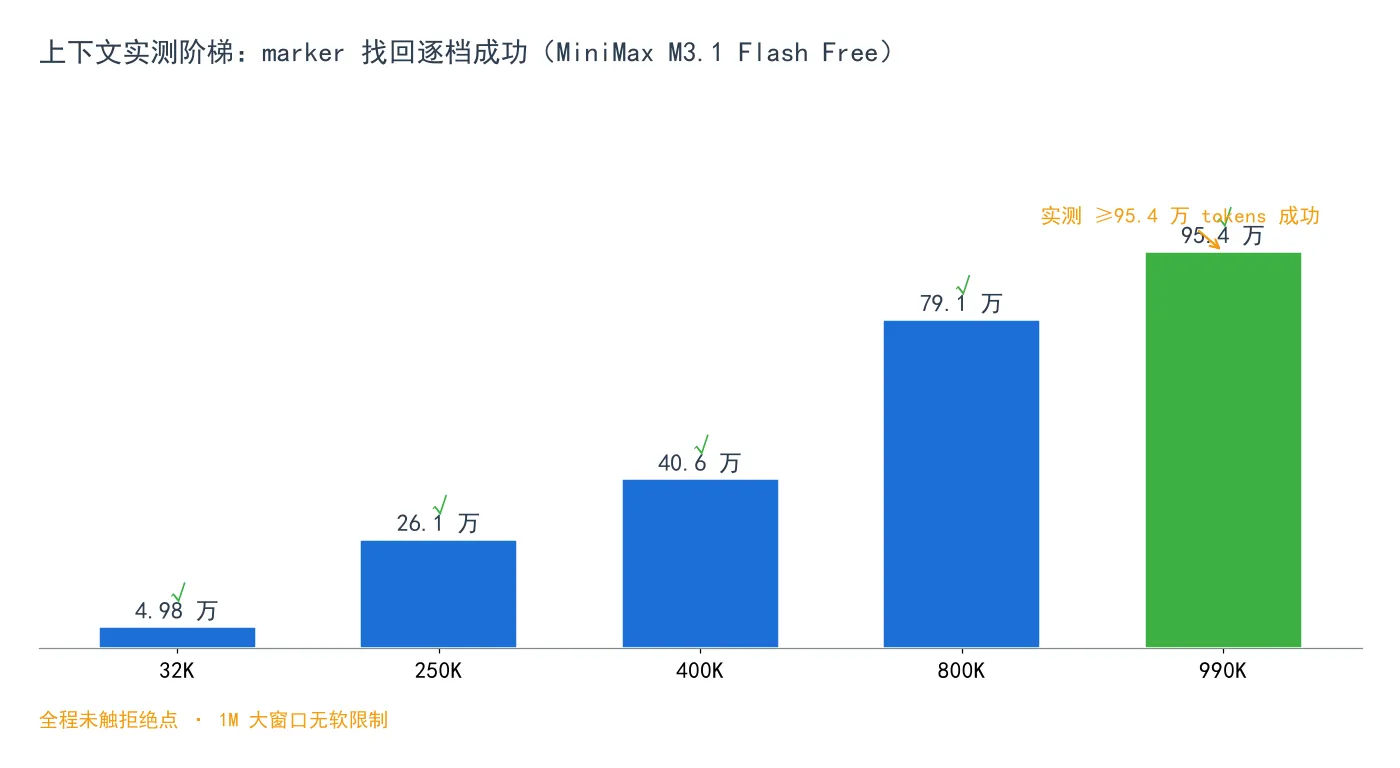
1M 大窗口是真的:用 marker 找回逐档往上顶,32K → 250K → 400K → 800K → 990K,每一档 marker 都能找回来,全程没碰到拒绝点,实测到 95.4 万 tokens 成功。但我不主张“上限=1M”——黑盒实测没顶到拒绝点,只能说“实测到 95.4 万成功”。
agent 工具调用 3/3:echo、ls、python 算个 2 的 10 次方,三个都是真实工具事件不是文本模拟,命令都正常退出。
稳定性:同一道冒泡排序连跑 5 次语义全对,但实现细节在漂移(原地排序/复制副本两种写法、注释差异)——语义稳、实现不机械复制。
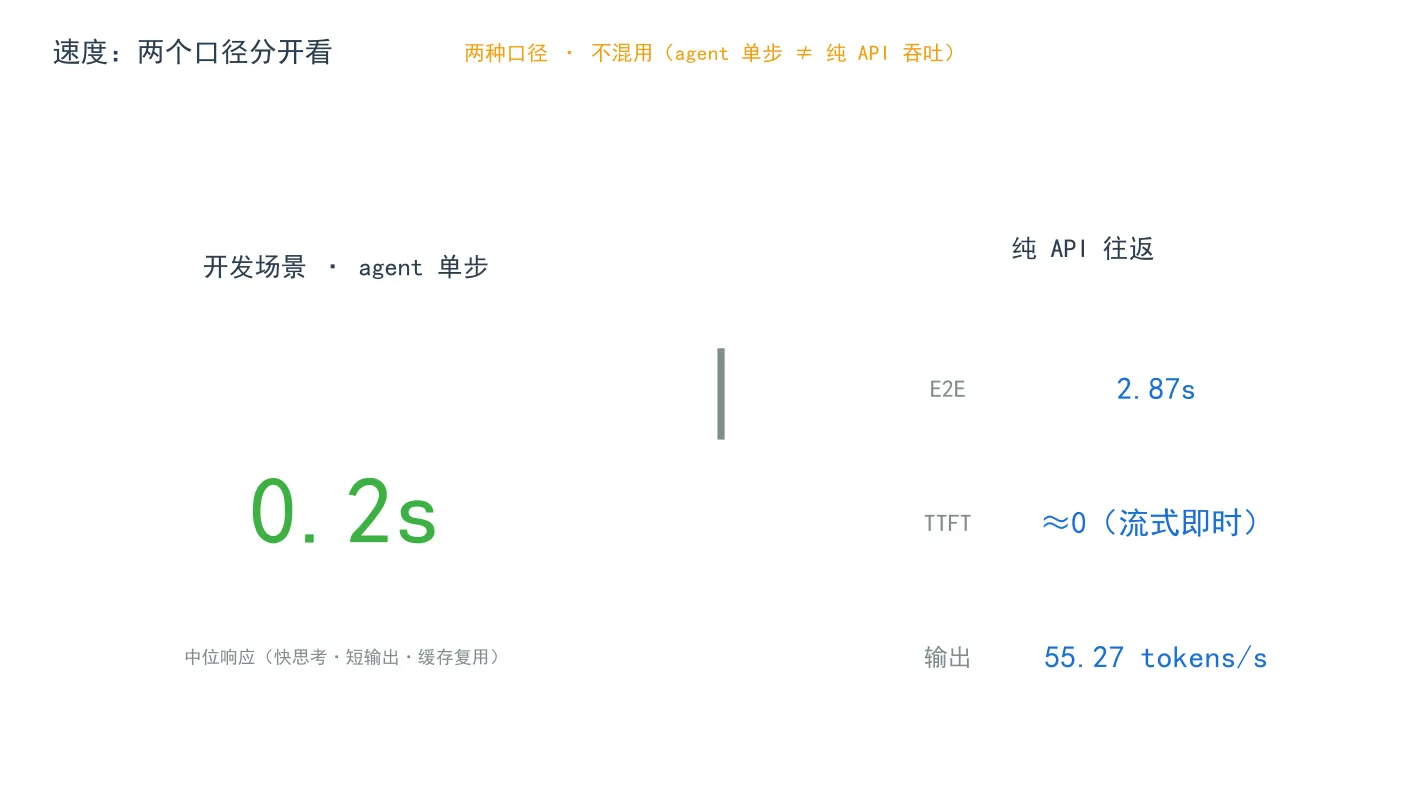
速度:开发单步响应中位 0.2 秒(agent 单步,快思考+缓存复用),纯 API 往返 E2E 中位 2.87 秒、首字基本秒出、输出约 55 个 token/秒。反正结论就一句:快。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。