腾讯混元 Hy4 flash Free 实测:首次上 1M 上下文,接近 1M 也全召回;输出却只有 64K
2026 年 11 月 16 日早上 08:00,OpenCode 免费档又上线了个国产模型 Hy4 Flash——这是腾讯混元的第一个 flash 版本,免费 $0,带 none / high 两档。最近国产各家都在发 flash 版,混元也开始凑热闹了。这次也是 Hy 模型首次给出 1M 上下文,不过输出反而比 Hy3 还小了,只有 64K。
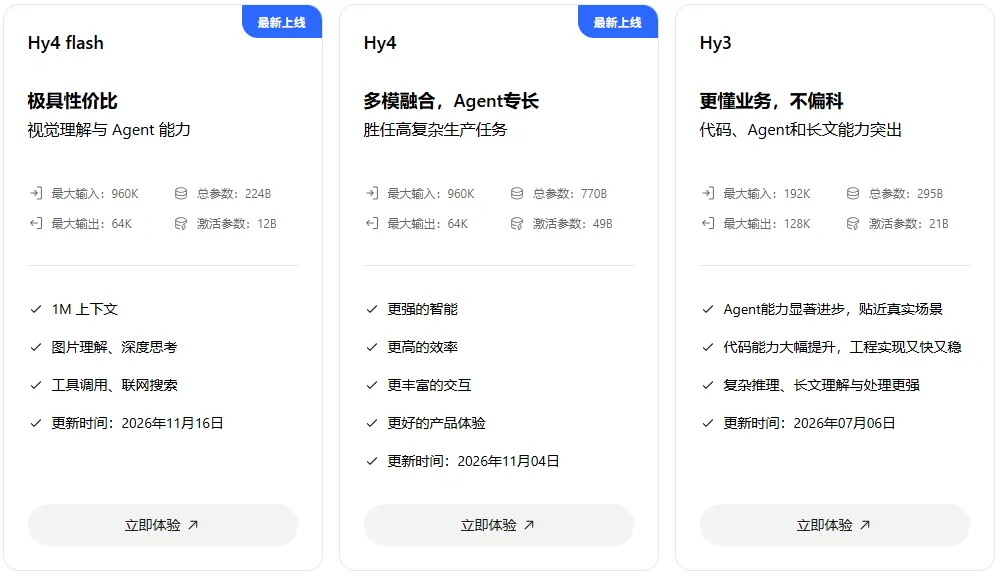
我这两天着重确认了下它的上下文情况,目前看来能力还可以,普通的编码任务还是可以用的。
先给结论:这个免费 flash 档能用,而且长上下文是真能打。实测 87.5 万 token 上下文里前中后三个位置的密码和大海捞针数字全部召回,不是纸面规格;基础能力四项全过。唯一要注意的是它输出上限只有 64K,跟国内大部分 128K 往上的模型比偏小。
下面是完整实测。
长上下文:接近 1M 不是摆设,实测 87.5 万 token 全召回
这次 Hy4 最大的提升应该是长上下文。Hy3 的时候还不到 200K,这次直接上 1M,跨度还是有点大的。我一步步堆上下文,最高塞进了 87.5 万 token(官方标的最大输入是 96 万,也就是测到了上限的 91%),前/中/后三个位置的密码全对,加的特殊数字也能精准找出。实测量级阶梯如下:
| 量级 | 实际注入 token | 模式 | 前中后+NIAH | E2E(s) |
|---|---|---|---|---|
| 143K | 143,486 | 全量 | 全对 | 19.88 |
| 613K | 613,113 | 全量 | 全对 | 37.24 |
| 686K | 686,693 | 全量 | 全对 | 36.78 |
| 756K | 756,628 | 全量 | 全对 | 39.84 |
| 834K | 834,056 | 全量 | 全对 | 45.85 |
| 875K | 874,930 | 全量 | 全对 | 45.36 |
11 个量级从 14 万到 87.5 万,每个都全量注入一次成功、信息全召回,没有中段丢失。能塞到这么高,靠的是中文高密度文本——OpenCode 单文件注入上限约 4.6MB,英文填充只能到 61 万 token,中文因为 token 密度高(约 0.55 token/字 vs 英文 0.17),4.59MB 中文文件就能塞进 87.5 万 token 还全量注入成功。所以这个数不是凑的,是真把这个量级的文本一次性喂进去让它读完召回。
再往上没测到精确点——因为 OpenCode 单文件全量注入上限就是约 4.6MB(87.5 万 token),造大一点的文件它就转 grep 了,不直接把内容塞给模型。官方上下文规格标的是 1M,但最大输入写的是 96 万(960K);聚合源直接标上下文 1M(1,048,576)——这个“上下文 1M / 最大输入 96 万”的说法差异,得等 API 直连通道验证,本次我没测到精确点,不下判断。
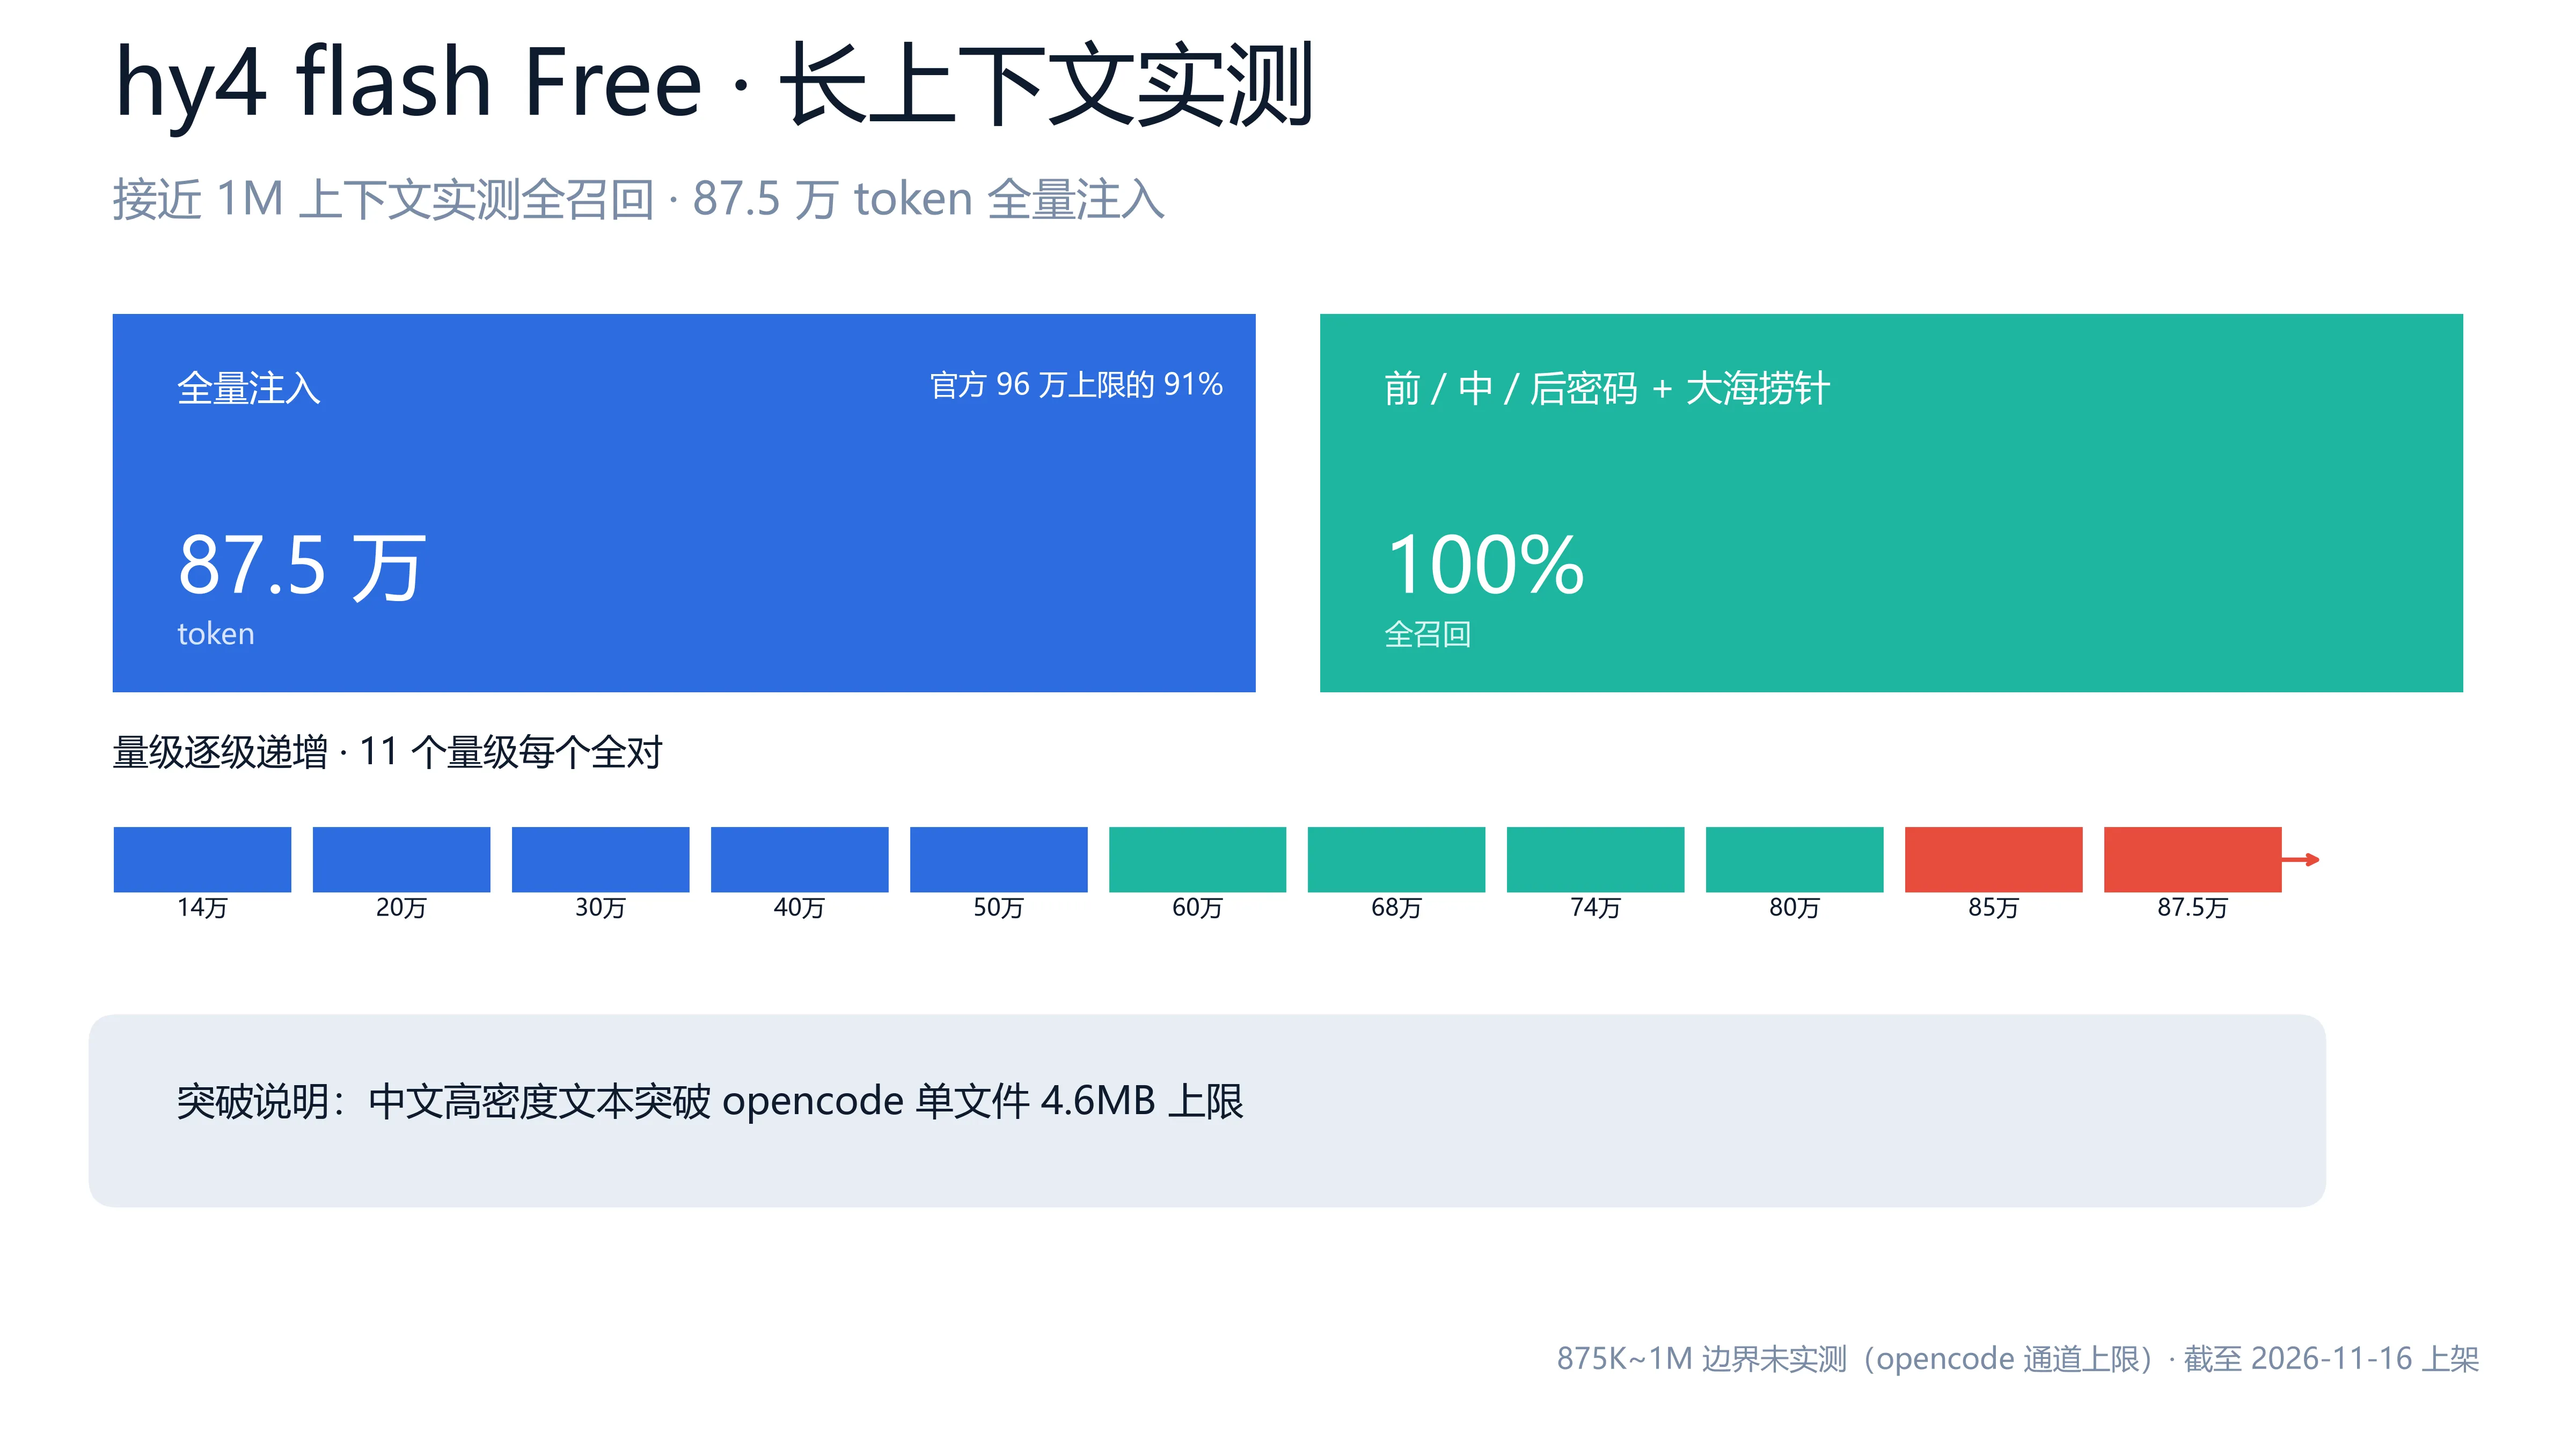
这张图是补测的长上下文量级阶梯:从 14 万到 87.5 万 token 全量注入,前/中/后密码 + NIAH 特殊数字每个量级都全对。
输出只有 64K:跟国内比偏小,但日常够用
输出上限 64K 是这次规格上最特别的一点。跟国内大部分其他模型相比,64K 输出有点小了——目前大部分都是 128K 往上,MiniMax M3.1 Flash 甚至给了 512K 最大输出。Hy4 单次响应最多吐 6.4 万 token,在这个区间里偏保守。
不过 64K 输出倒也不是不能用:平常使用一下子输出很大的情况还真不多,相比来说长上下文倒是使用频率更高。所以普通问答、编码、日常推理这类短输出,64K 完全够,单次响应不会碰到这个天花板;只有要一次性生成特别长的内容时,64K 会卡住。够不够用,取决于你的任务类型。
干活能力:基础四项全过,中文长文一次过不截断
基础能力上也都还可以,测试任务全部通过:
| 维度 | 结果 | 判定 |
|---|---|---|
| 中文长文 | 6479 字符技术长文,引言+10 分节+结语,单次完整无截断 | 5/5 |
| 数学 | 不定积分、抽球概率全对,无放回理解正确,双法验证 | 5/5 |
| 代码 | JSON 解析器编译 0 错,22/22 测试通过 | 5/5 |
| 推理 | 错标盒子题正确,推理完整含反证 | 5/5 |
中文长文是最亮眼的——6479 字符的技术文一次生成不截断、结构完整,不是那种开头洋洋洒洒、结尾戛然而止的半成品。数学把“无放回”的抽屉理解得对,还主动给了双法验证。代码是完整的可运行产物,编译零报错、测试全过。
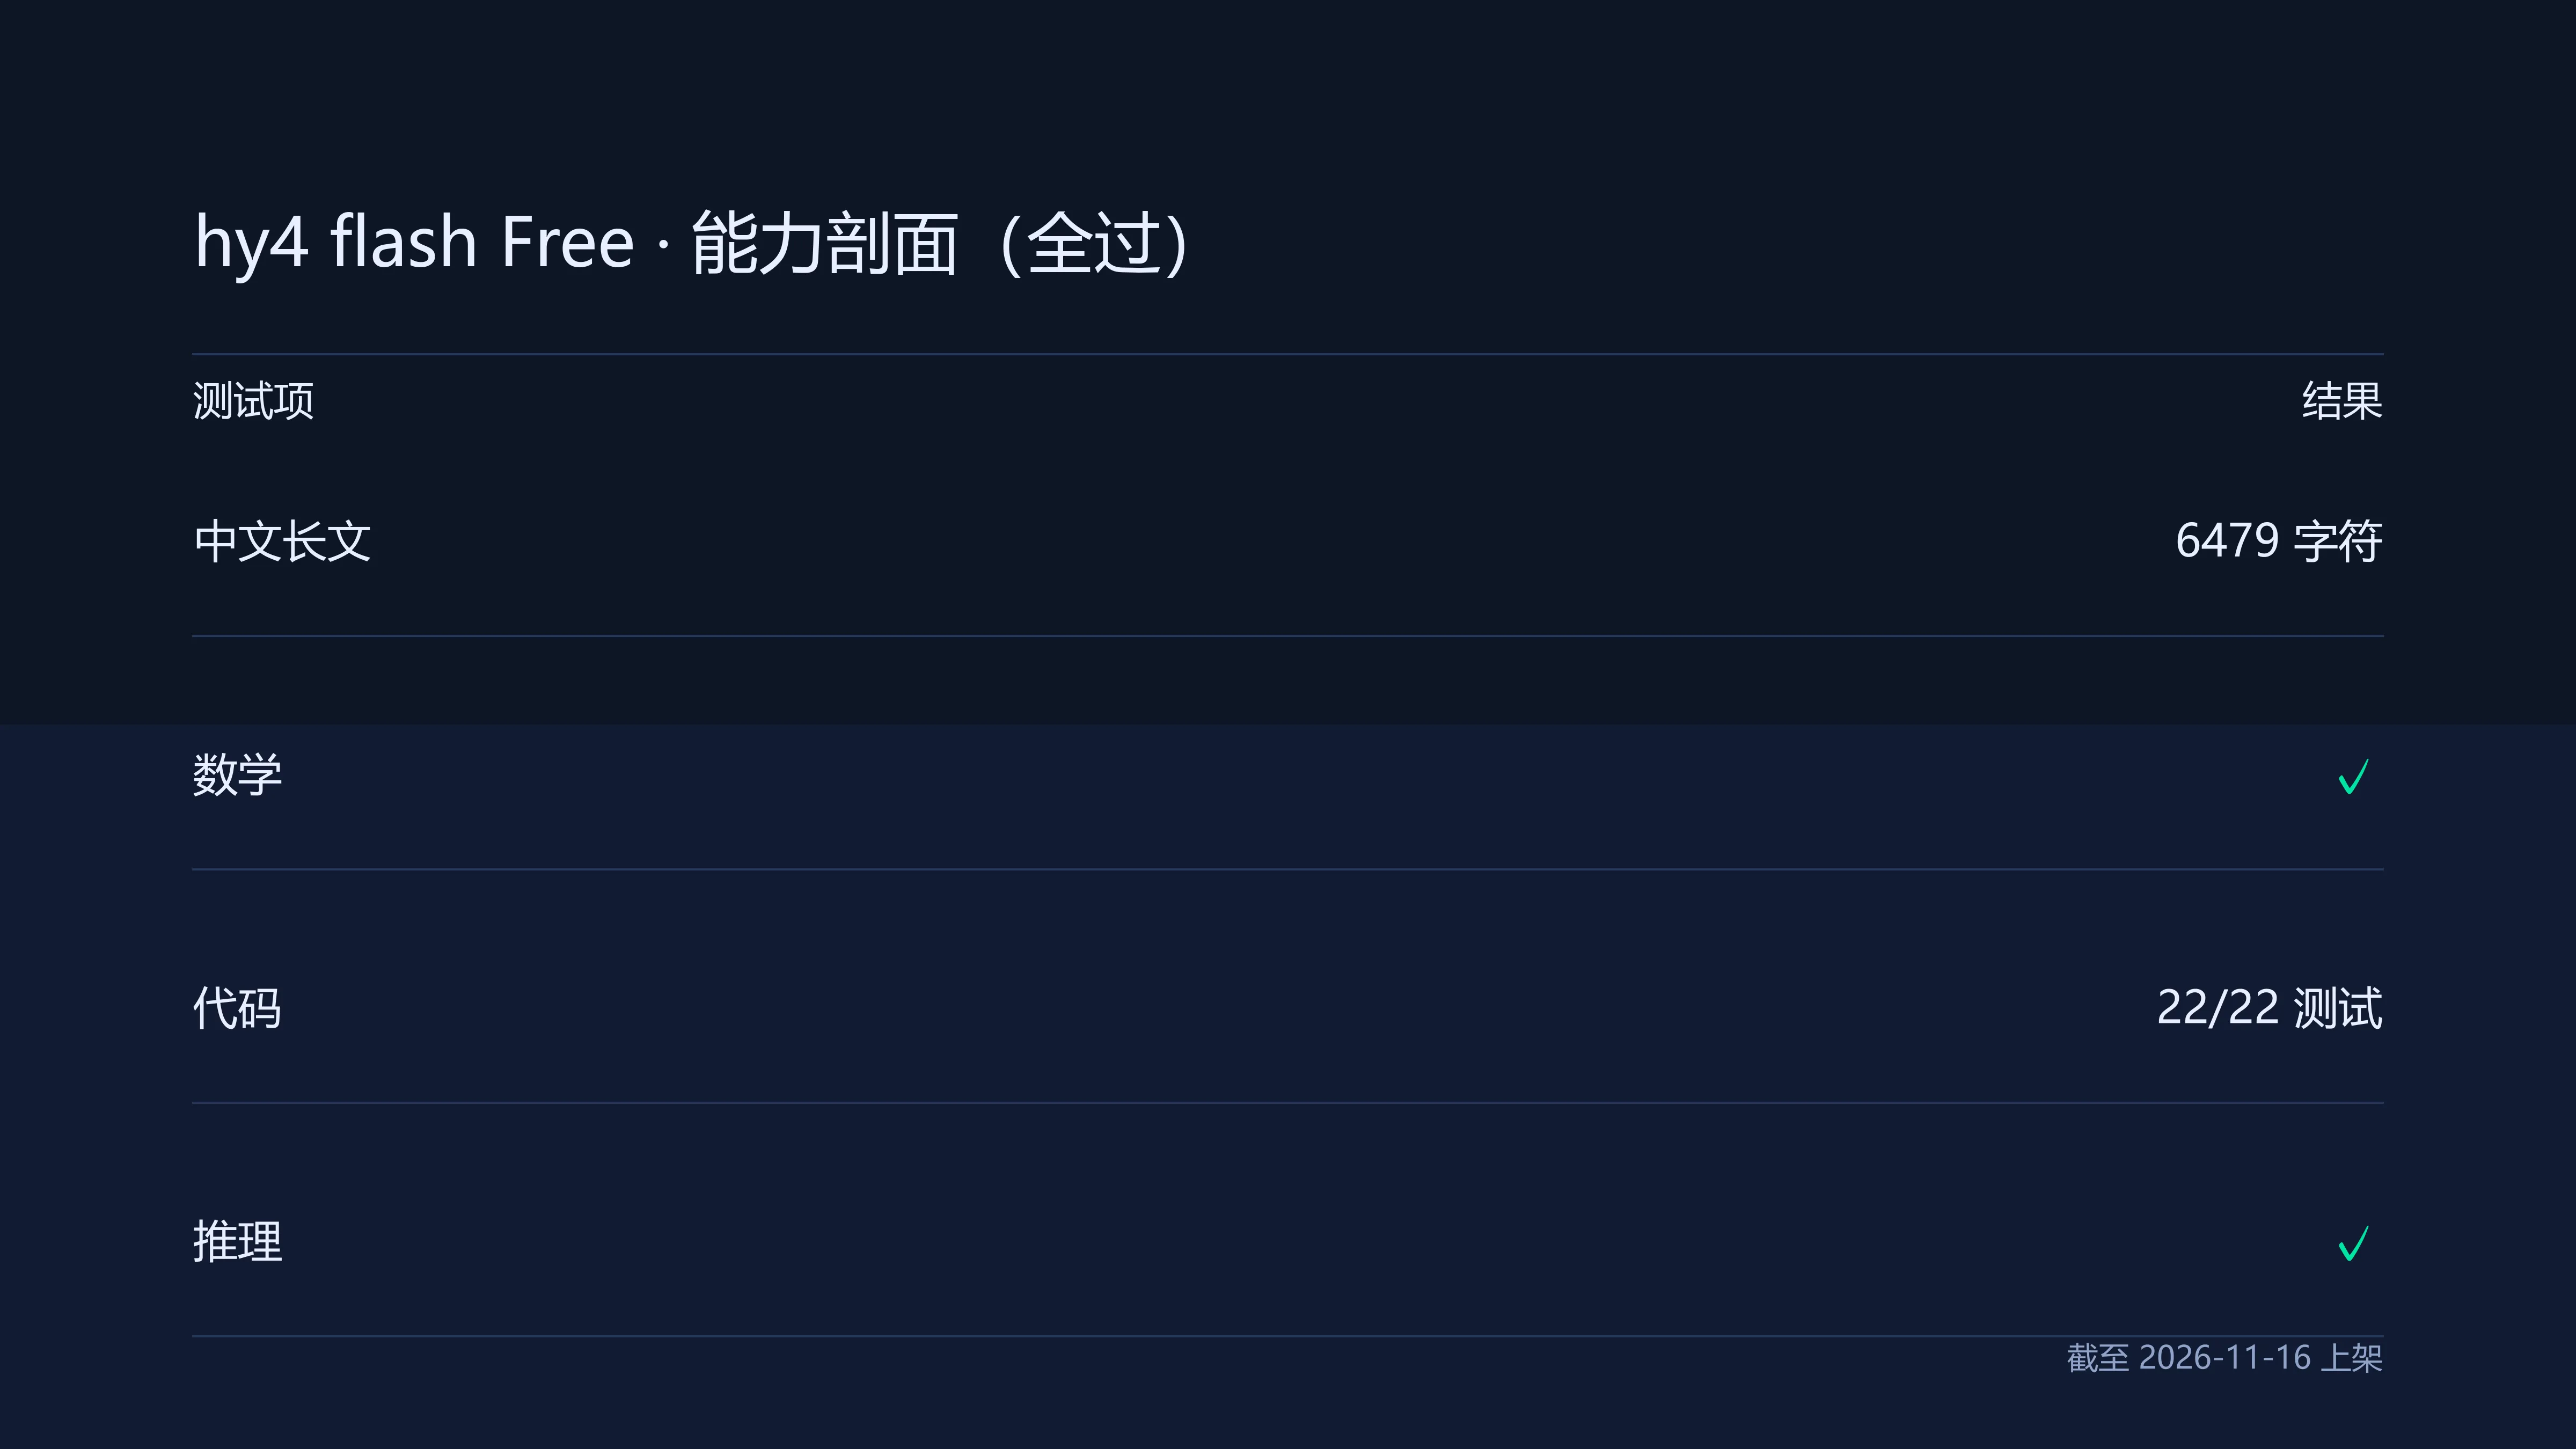
这张图汇总四项任务判定结果,全部通过。
速度:符合 flash 快速轻量档
速度上单点短任务 E2E 中位 6.49 秒、39.4 t/s(none 档),符合 flash 快速轻量档定位。它还有一档 high 是深度思考:拿同一个推理题,high 档 E2E 29.71 秒、输出长 11.7 倍,两档完成度都达标。
诚实性:会拒绝压力式刷输出,也会拒猜规格
这个免费档的诚实性是我没想到的加分项。
我试了几次压力式超长输出请求(明显在刷输出量、测截断边界),它识别出这种压力模式后直接坦诚拒绝,不硬着头皮刷输出——不糊弄你,也不给你灌水。补测长上下文时我又问了它 context window 和型号,它明确说“凭猜测回答违反诚实性原则”,让我去查 models.dev,不编规格。还自己发现文件名标 1M 但内容实际是 200K 的文档,主动指出来不将就。
这种“识别压力请求并拒接、不懂就明说”的行为,比那种不管三七二十一给你堆 token 的模型舒服多了。
用不用:值得尝试,趁它在架
值得尝试,最近 OpenCode 上免费档国产模型出镜率贼高,各家模型都有提升。如果你看重“免费 + 超长上下文 + 能力全面 + 诚实”,这个档顶得上去——尤其接近 1M 的上下文,对处理长文档、大上下文检索是实打实的优势。
几个要留意的点:
- 注意输出上限:64K 单次输出对超长内容生成会卡,适合短输出任务,要生成超长内容得注意这个限制。
- 一个待确认点:官方上下文标 1M、最大输入写 96 万,聚合源直接标上下文 1M——这个说法差异本次只实测到 87.5 万(OpenCode 通道上限)就上不去了,要确认精确边界得等 API 直连通道。
时效要讲清楚:OpenCode 免费池轮换很快,这两天 GLM 5.3 Flash 免费档就下线了。不过据我观察,Hy3 在免费档里待的时间算中等,不长也不短,可以尽早体验,后面想付费心里也有数。
一句话:腾讯混元第一次做免费 flash 变体,就交出一份接近 1M 上下文全召回、能力全优、输出 64K 偏小但日常够用、还会诚实拒猜规格的答卷。趁它在架,值得试一把。
实测环境:opencode run CLI v2.3.0 / Windows / Python 3.12。结论仅对 opencode/hy4-flash-free(2026-11-16 上架)本次实测会话有效。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。