智谱官方免费额度实测:注册送 token 驱动 80% UI 开发,但有两个坑(2026-10)
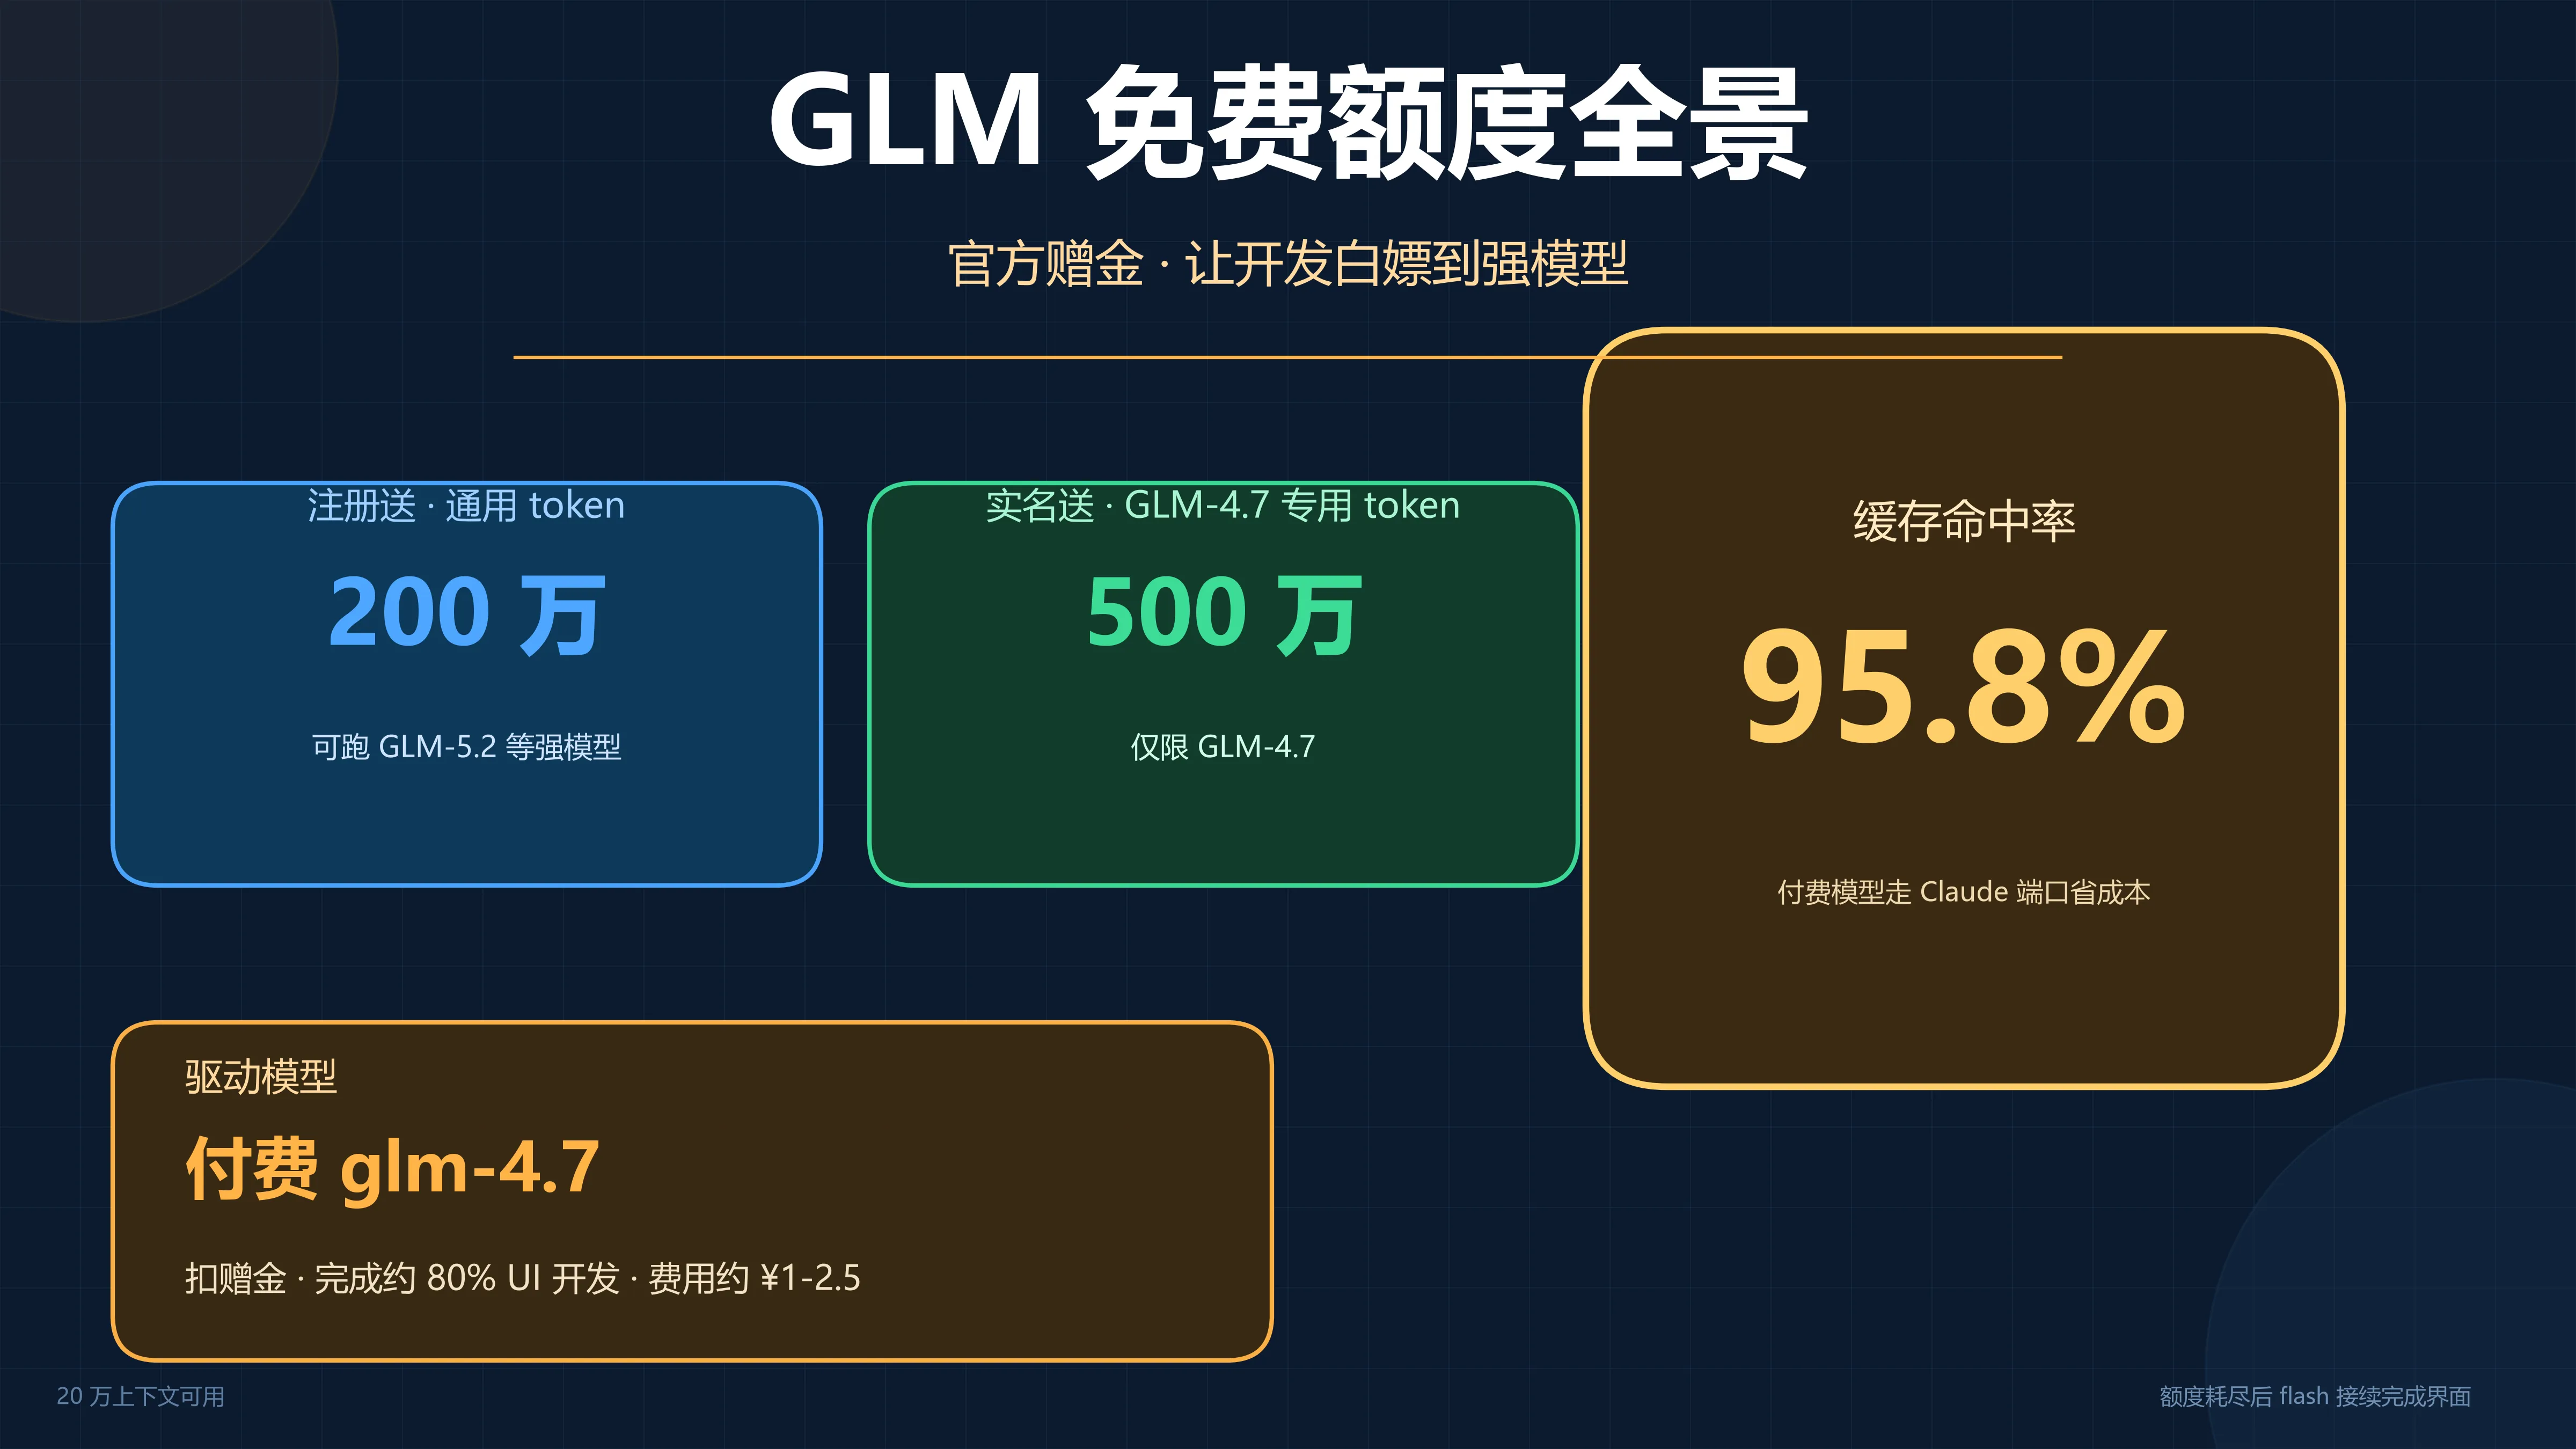
智谱注册送 200 万通用 token、实名再送 500 万 GLM-4.7 专用 token。我拿这笔官方赠金跑了趟真实开发:重构一个小型 WPF 单媒体图像生成工具的 UI。开发 2026-10-21 晚 21:19 到 22:12,约 53 分钟,消耗 689.4 万 tokens,计费 33.2 万、约 ¥1-2.5(扣通用赠金)。这一轮验证三件事:这笔免费额度(赠金)能否驱动真实开发、额度包怎么扣、模型埋头写代码时在哪摔跤。
这笔官方免费额度(赠金)能驱动真实开发——注册 200 万通用 + 实名 500 万 GLM-4.7 专用,驱动付费 glm-4.7 完成约 80% 的功能代码开发,只花约 ¥1-2.5(扣通用赠金)。但会话暴露两个坑——额度包被按“先到期”乱扣、模型重代码轻验证导致端到端失败。
一、成本与速度
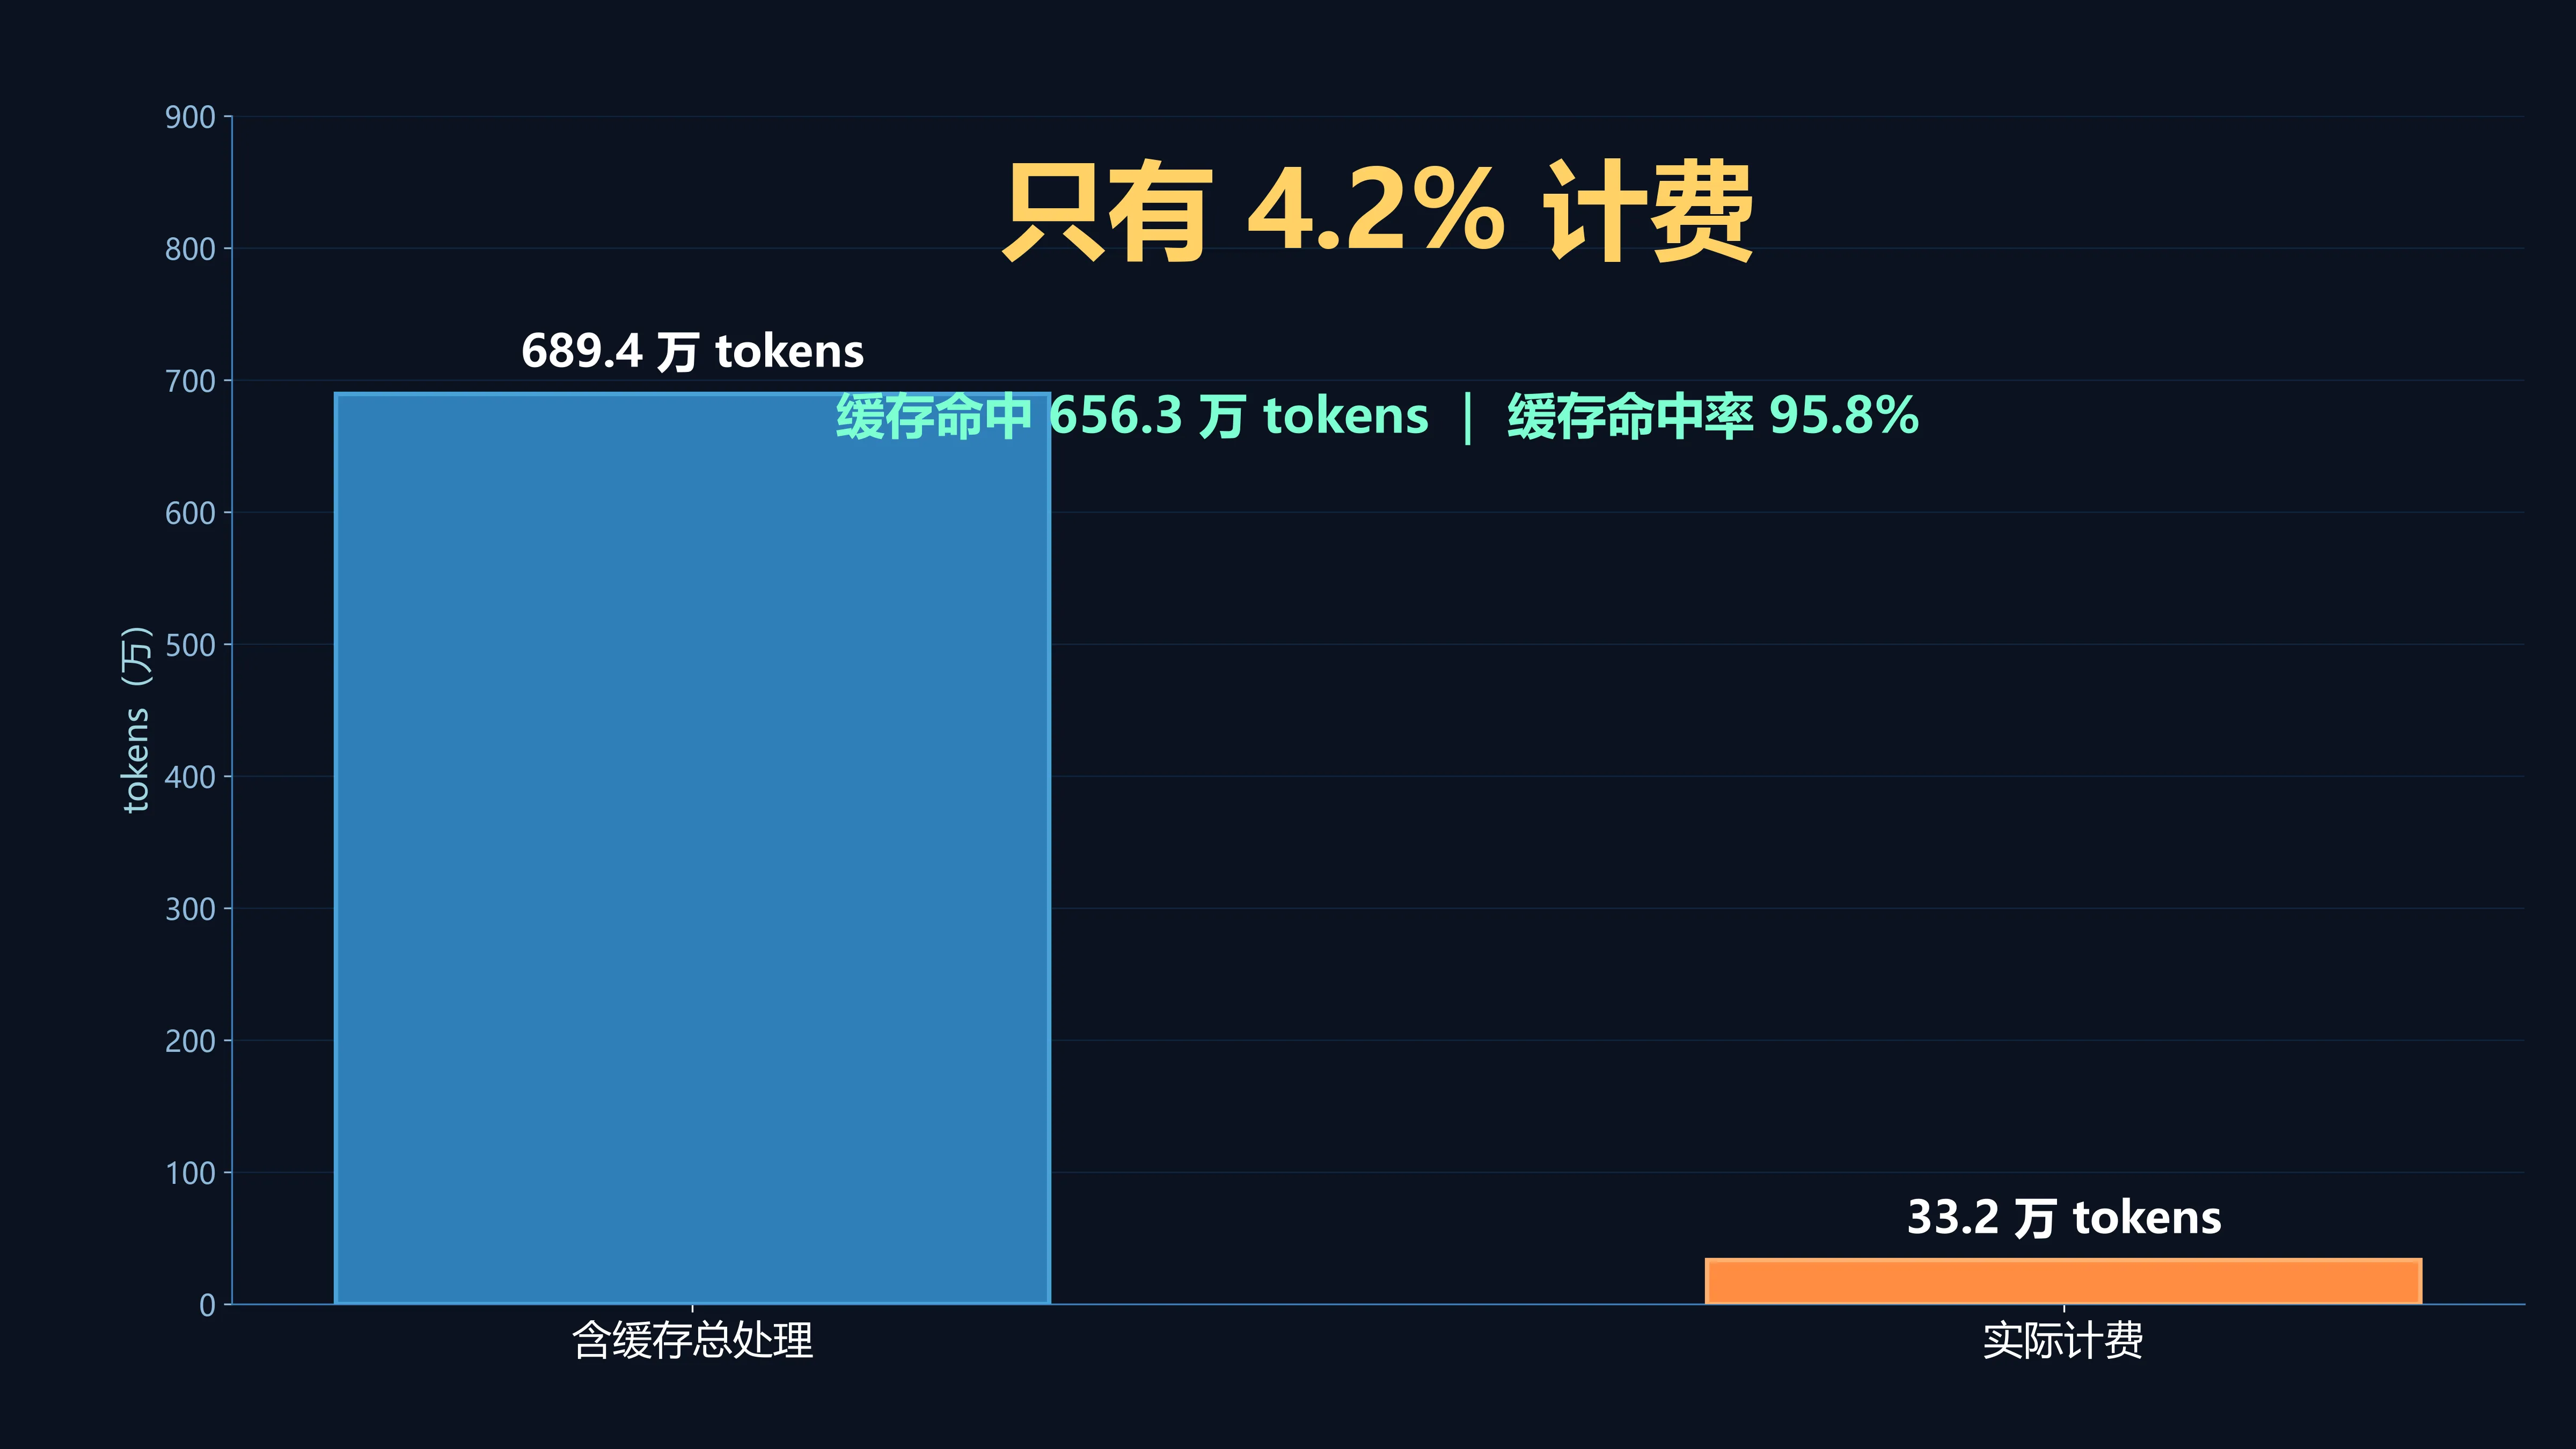
- token 用量:总处理 689.4 万(含缓存命中 656.3 万),实际计费 33.2 万,费用约 ¥1-2.5,从注册送的通用赠金扣。压缩 0 次。
- 缓存命中率:走智谱官方 Anthropic(Claude 兼容)端口,实测 95.8%,未命中输入仅 4.2%。
- 耗时:实际有效开发约 53 分钟(21:19→22:12),额度耗尽即停。
| token 用量指标 | 数值 |
|---|---|
| 输入 tokens(未命中缓存) | 28.9 万 |
| 输出 tokens | 4.2 万 |
| 缓存命中输入 | 656.3 万 |
| 总处理 tokens(含缓存) | 689.4 万 |
| 实际计费 tokens(不含缓存) | 33.2 万 |
| 压缩次数 | 0 |
缓存命中率:这次全程走付费 glm-4.7,Anthropic(Claude)端口实测命中 95.8%、未命中只有 4.2%,直接帮付费模型省成本。我之前用 OpenAI 端口时命中率低不少,所以这次跑长任务就选了 Claude 端口。
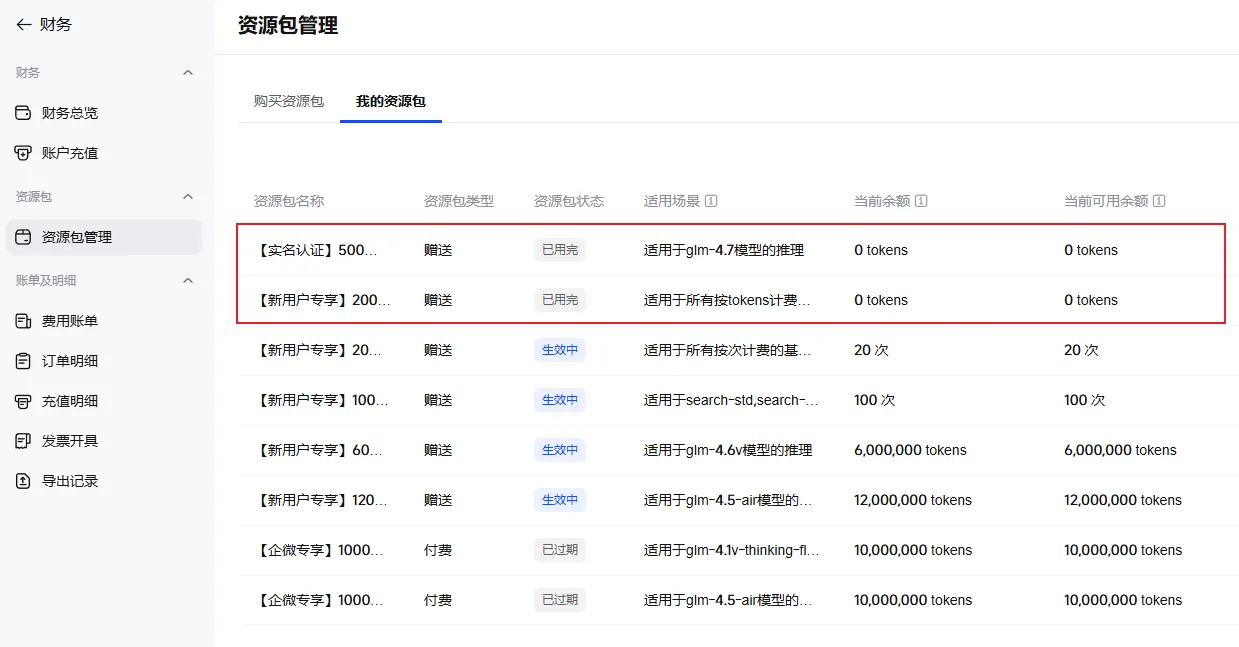
智谱送的资源包信息:
再看下 token 用量和缓存命中:
二、功能实现情况
这次用付费 glm-4.7(20 万上下文、13.1 万单次输出、thinking 推理开着)跑真实开发,完成的功能清单:
| 功能 | 完成情况 |
|---|---|
| 主窗口布局重构(左侧竖排导航 + 右侧工作区) | 完成,重写 MainWindow.xaml |
| 生图工作区 + 手绘遮罩 + 眼镜遮罩工具 | 完成,新增 ImageGenWorkspace |
| 设置页(供应商/模型配置,存本地配置) | 完成,新增 SettingsView |
| 配置服务 | 完成,新增 SoloMediaConfig |
| ViewModel 导航切换 + 遮罩命令 | 完成,重写 MainViewModel |
| UI 自动化测试 | 从头到尾没跑起来(应用启动即崩溃) |
三、关键发现
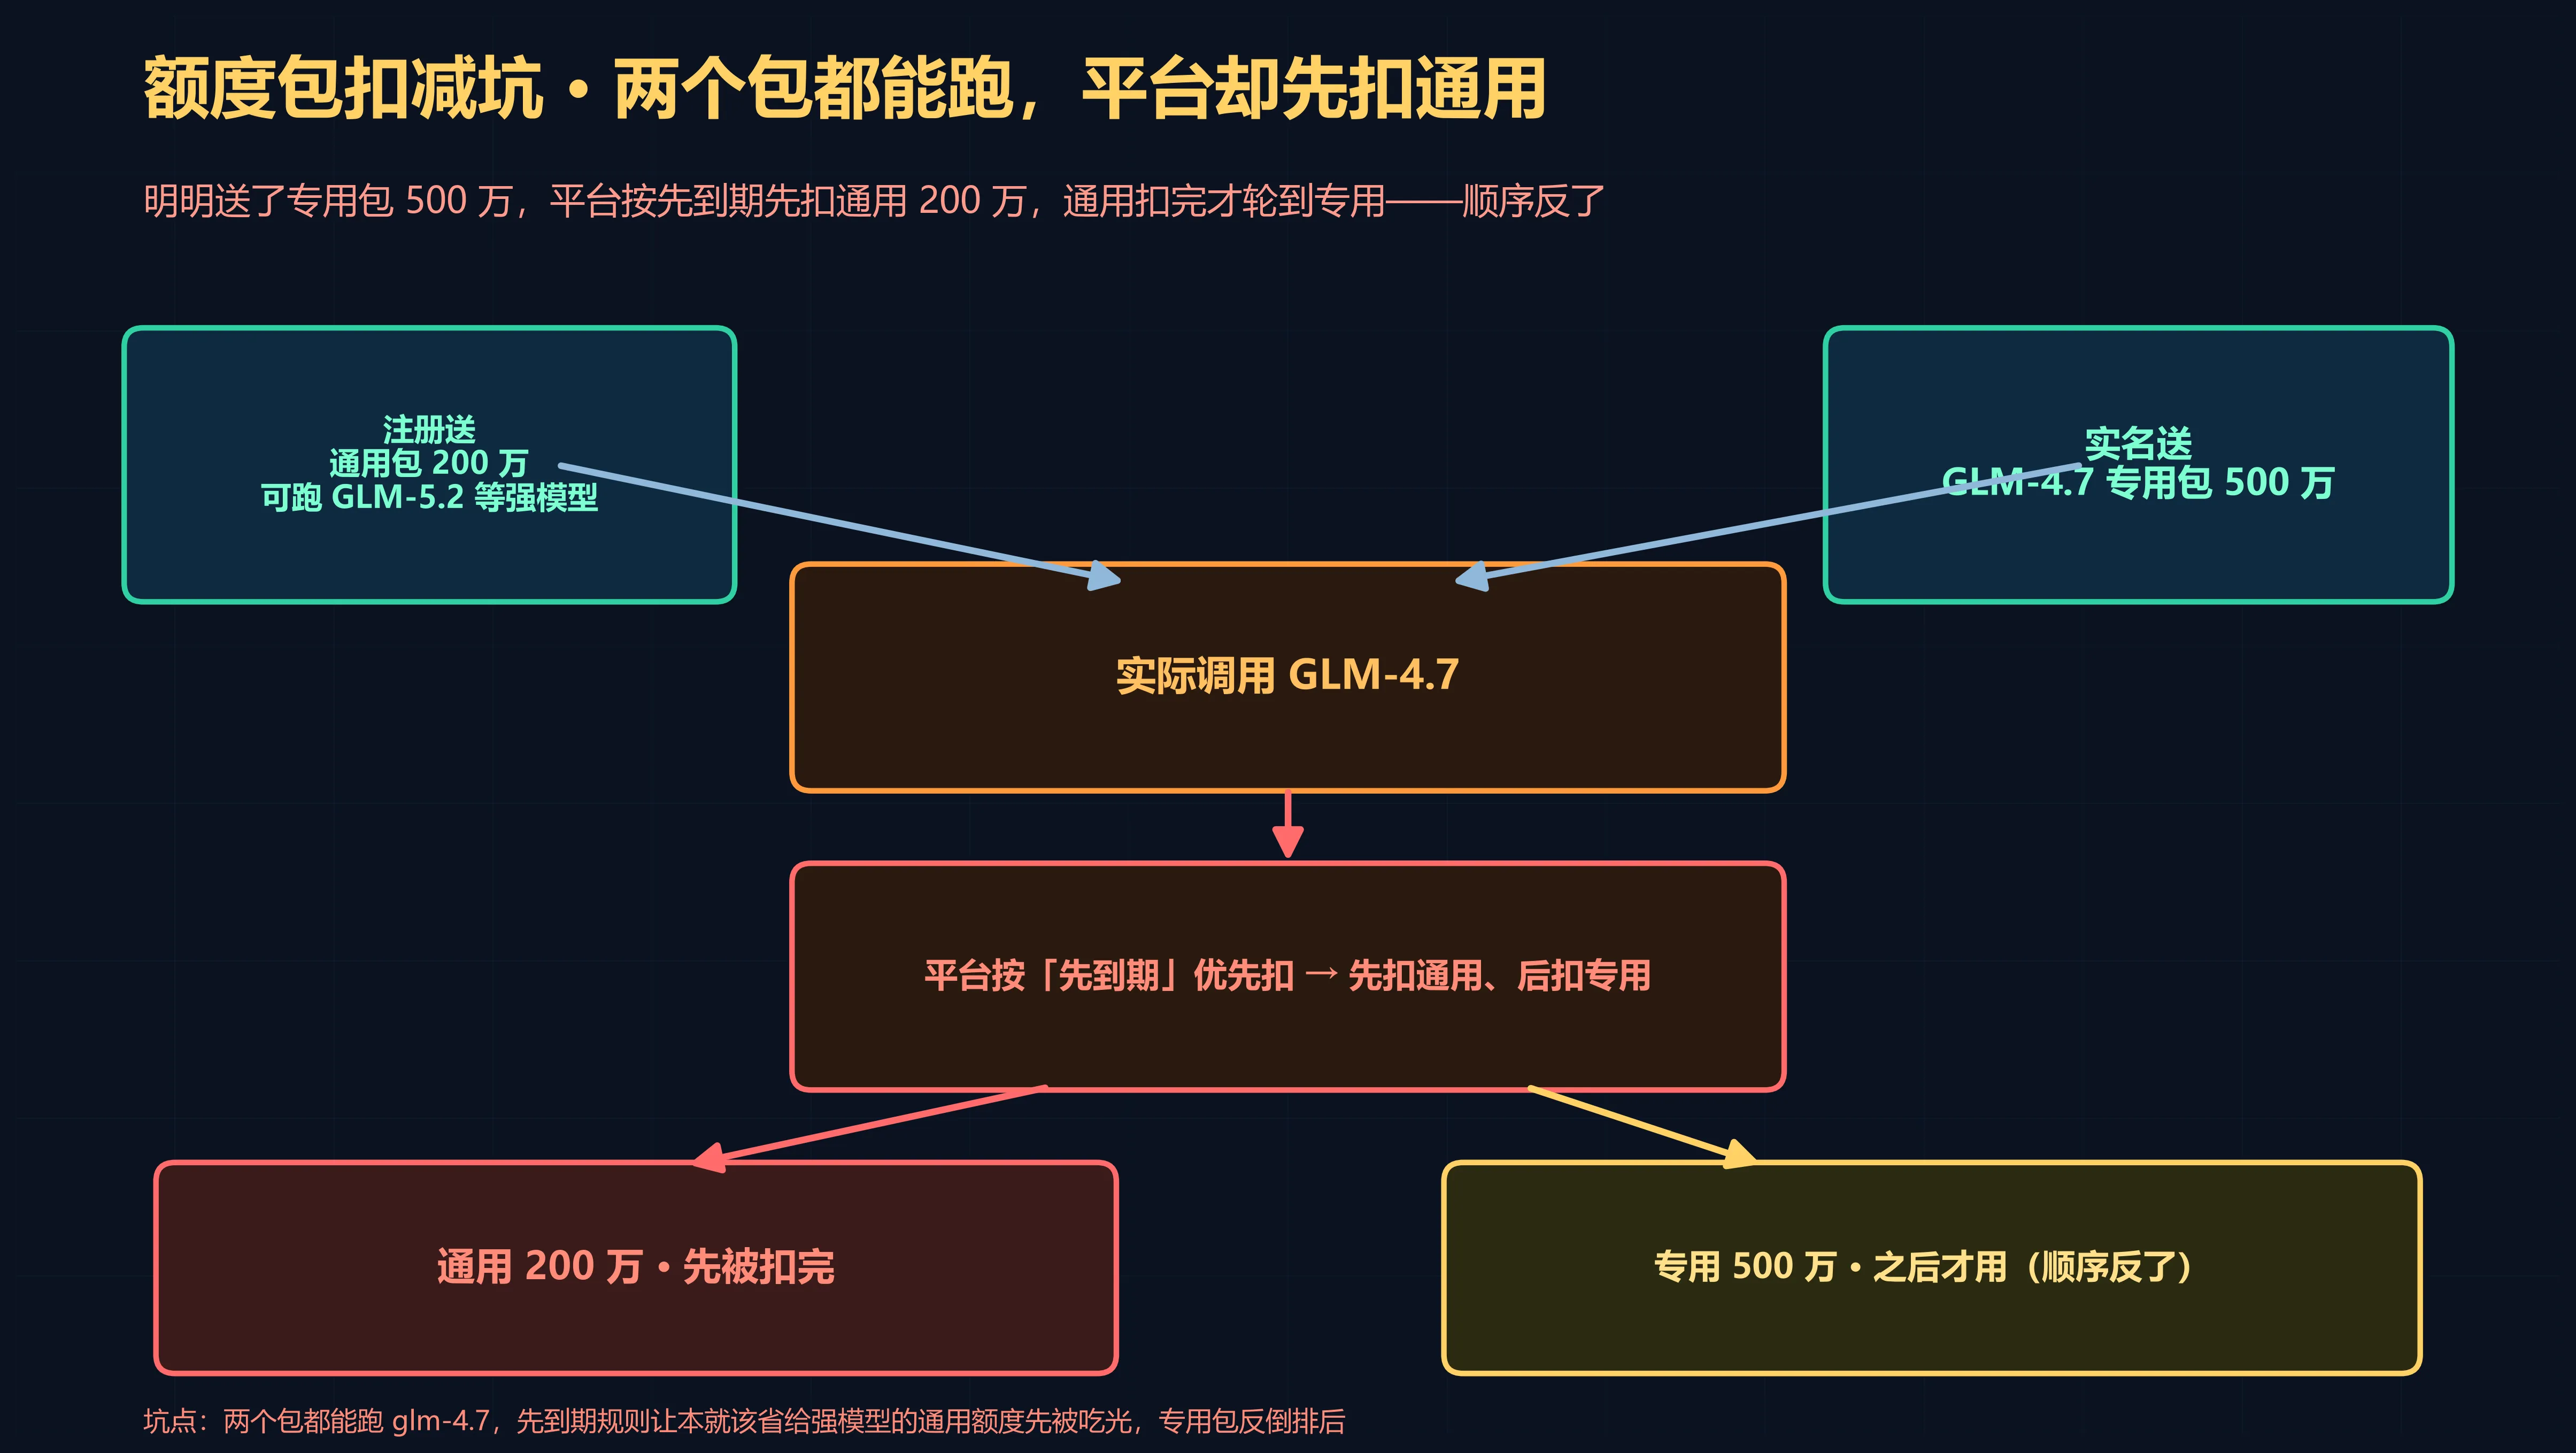
额度包扣减的坑。 注册送 200 万通用包(更灵活,能跑 GLM-5.2 等更强模型),实名送 500 万 GLM-4.7 专用包(本应专门跑付费 glm-4.7)。官方扣费顺序:①优先扣满足模型适用场景的资源包,②多个同场景按先到期优先,③最后扣现金。我原本预期 glm-4.7 走实名专用包、把通用留给强模型,但实际平台按“先到期”优先,先把通用包扣完了,之后才轮到专用包——顺序反了,宝贵的通用额度被 glm-4.7 先吃掉,专用包反倒后动。
| 额度包 | 来源 | 预期用途 | 实际 |
|---|---|---|---|
| 200 万通用 token | 注册 | 留给 GLM-5.2 等更强模型 | 被 glm-4.7 先扣完(约 ¥1-2.5) |
| 500 万 GLM-4.7 专用 token | 实名 | 专跑付费 glm-4.7 | 通用包扣完才轮到它,顺序反了 |
UI 验证的坑(重代码轻验证)。 应用 UI 重构后,模型从没先启动应用验证能否运行,直接进入改测试代码环节。我 4 次催它跑 UI 自动化,模型前 11 分钟一直在改测试和功能代码,直到 21:54 我点破“没跑起来吧”才第一次跑 UI 测试——七步全失败。根因是应用启动即崩溃(主窗口未找到、进程直接退出),到会话结束也没解决。这是典型的“模型埋头改代码、不验证可运行性”陷阱。
这一轮下来,这笔免费额度(赠金)确实能驱动付费 glm-4.7 完成真实开发(约 80% 功能代码,仅花 ¥1-2.5);付费 glm-4.7 开发能力不错;额度包存在“按先到期乱扣”的行为;Claude 端口缓存命中率高。
四、干活能力
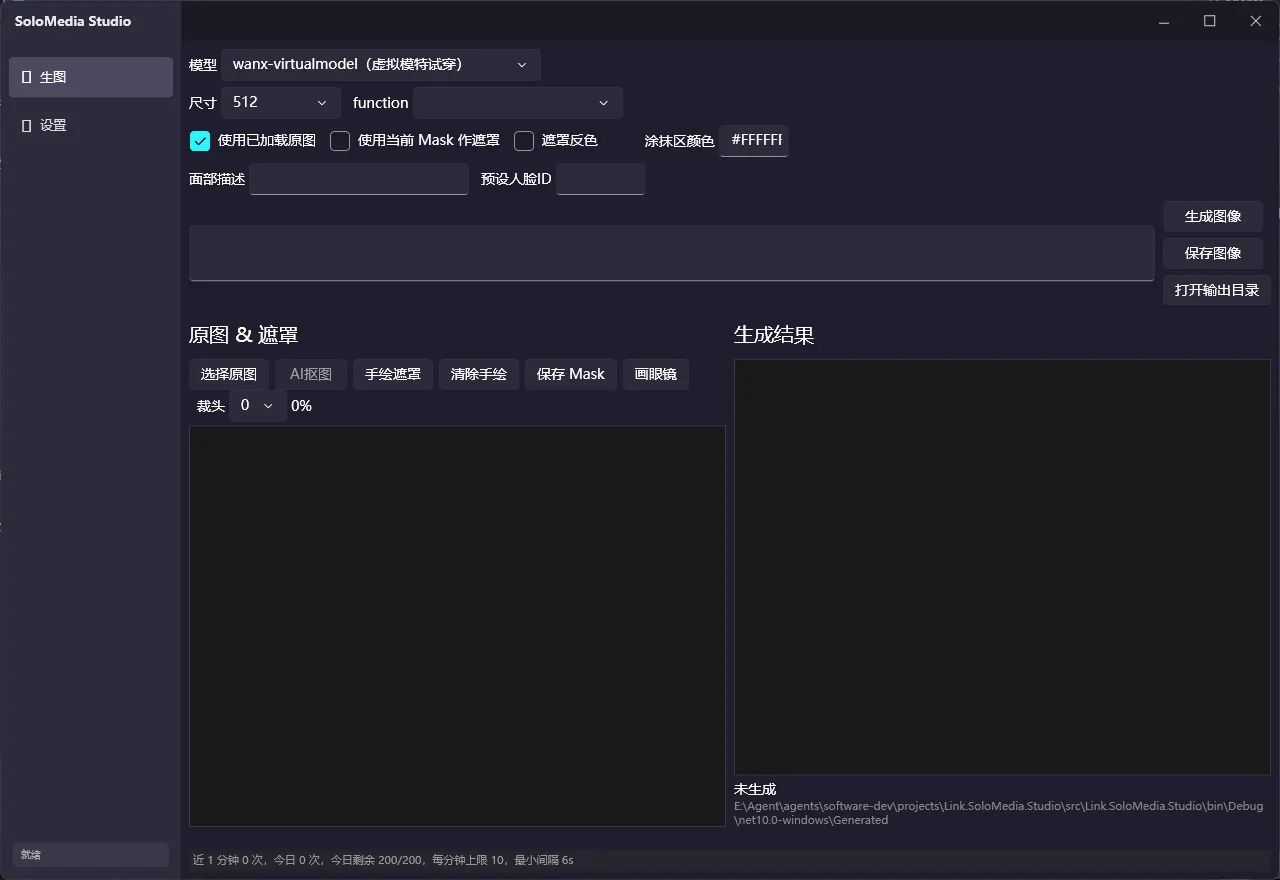
干了什么:完整重写主窗口布局、新增生图工作区、手绘遮罩、眼镜遮罩工具、设置页,新起配置服务。构建 8 次、单元测试跑 5 次都通过,功能代码约 80%(本来就没打算提交)。
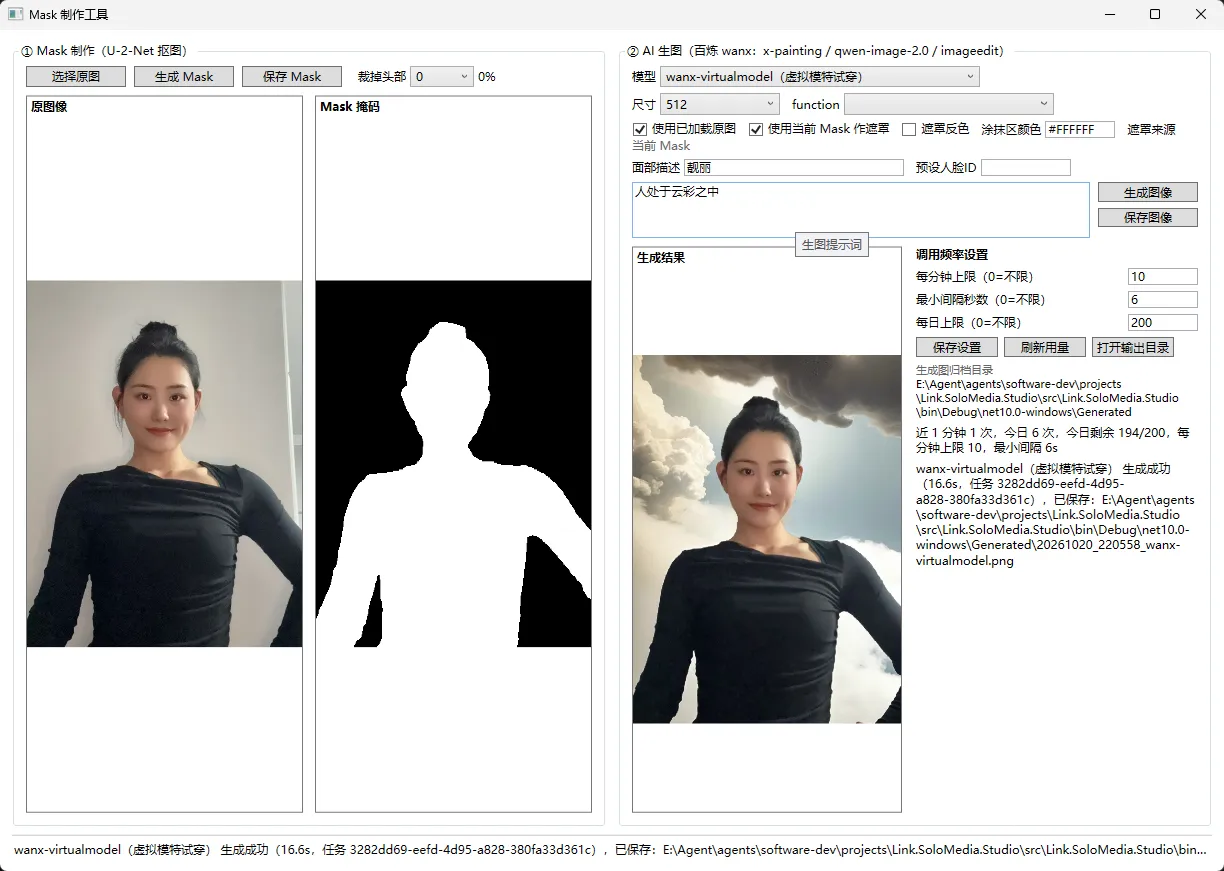
界面重构前长这样:
重构后这样——不过得说清楚:免费额度这次没把 UI 实现完,后来我换用 opencode 的免费 glm 模型(glm-5.3-flash-free)接续跑完的:
问题出在:端到端验证(UI 测试)因为应用启动崩溃全失败。token 产出比正常(输出 4.2 万对输入 28.9 万,约 1:6.8),主要浪费在反复改 UI 测试代码却没先抓住“应用起不来”这个根因,约 3 轮工具调用、约 4 万 tokens。
五、测试方法与判定标准
| 维度 | 怎么测 | 判定标准 |
|---|---|---|
| 成本/效率 | 统计 token 用量与费用 | 产出比正常(约 1:6.8)、费用可控(¥1-2.5) |
| 能力 | 真实 UI 重构任务 | 能自主完成布局重构 + 新增功能 |
| 完成度 | 功能代码 + 端到端验证 | 代码约 80%,但端到端验证全失败 |
| 问题排查 | 跑 UI 自动化测试 | 没先验证应用能否启动,根因未解 |
| 缓存效率 | Claude 端口实测命中率 | 95.8%(本次实测) |
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。