opencode 免费模型 GLM-5.3-Flash-Free 实测:免费档 20 万上下文不缩水,检索边界 50 万~60 万(2026-10)
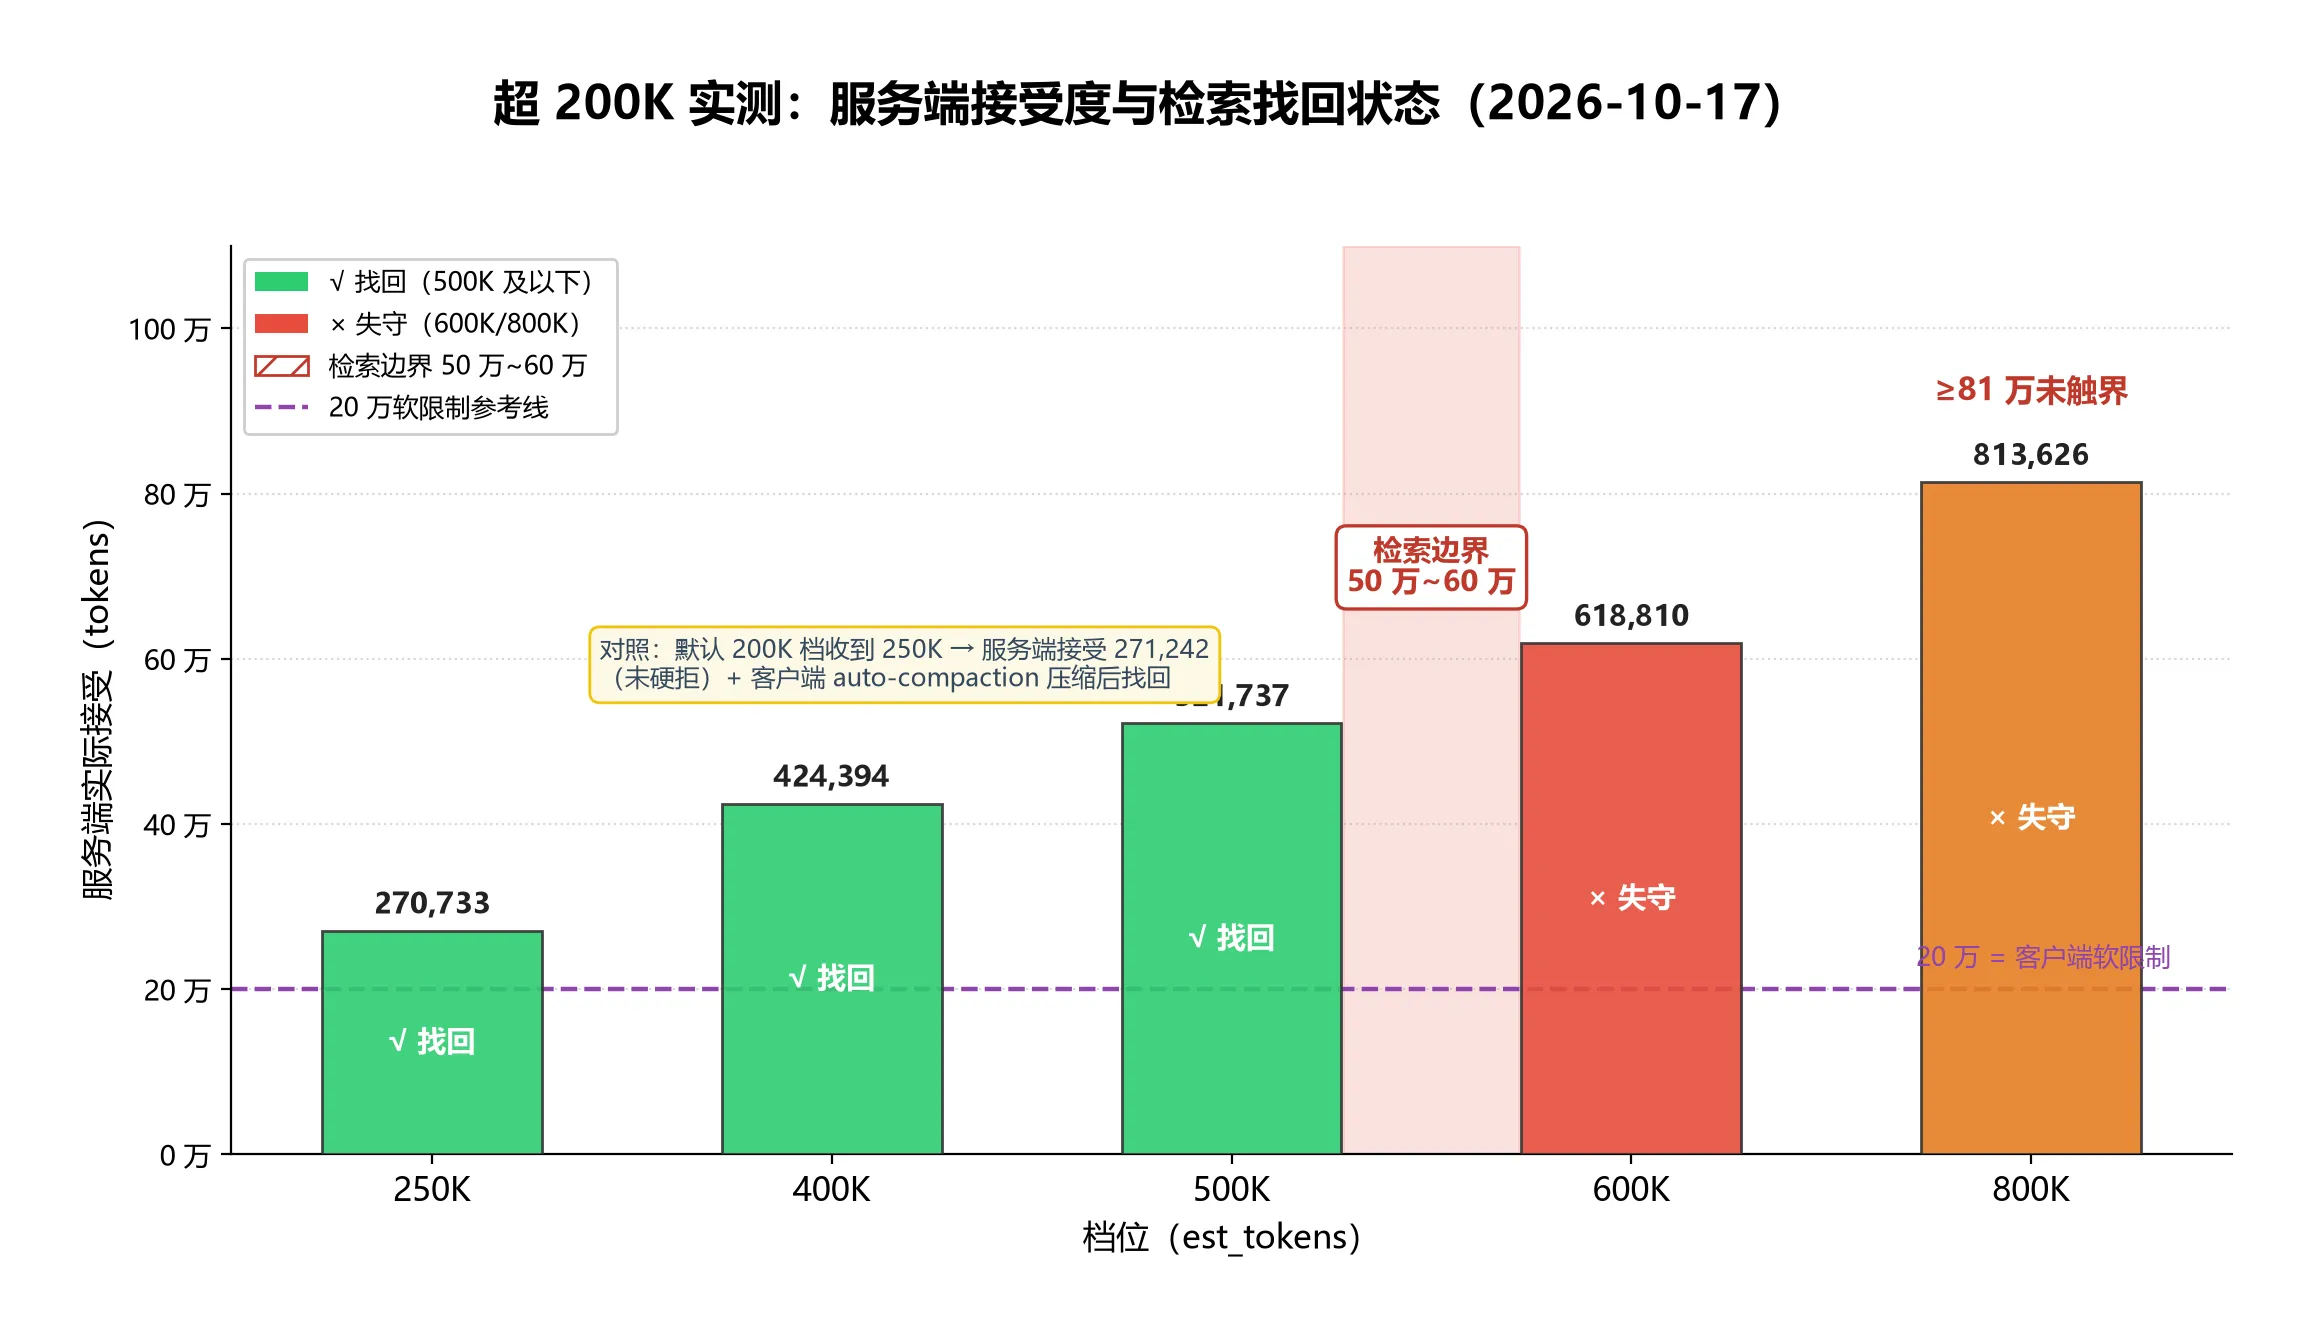
先说核验结论:opencode 免费档位 10 月 16 号上架的 GLM-5.3-Flash Free,配置上下文 20 万、输出 3.2 万,与同型号付费档/官方声明的 100 万上下文、13.1 万输出不符——但这是配置层差异,不是权重缩水。实测证明:20 万是客户端软限制,不是服务端硬限制——本地把配置上限从 20 万放开到约 105 万,再拿 250K/400K/500K/600K/800K 五档去试,服务端全部接受(实测最高 813,626 tokens,正常返回无 400/413);而默认 200K 档收到 250K 请求时服务端也接受 271,242 未硬拒,是客户端自动压缩上下文后继续找回。服务端硬上限未触界,只能说 ≥81.4 万未触界。真正的边界在模型检索:500K 找回、600K 失守,800K 档服务端接受但输出无关填充词。本次实测是单机单场景(win32、opencode CLI 1.19.3)。
一、这次测的对象与配置
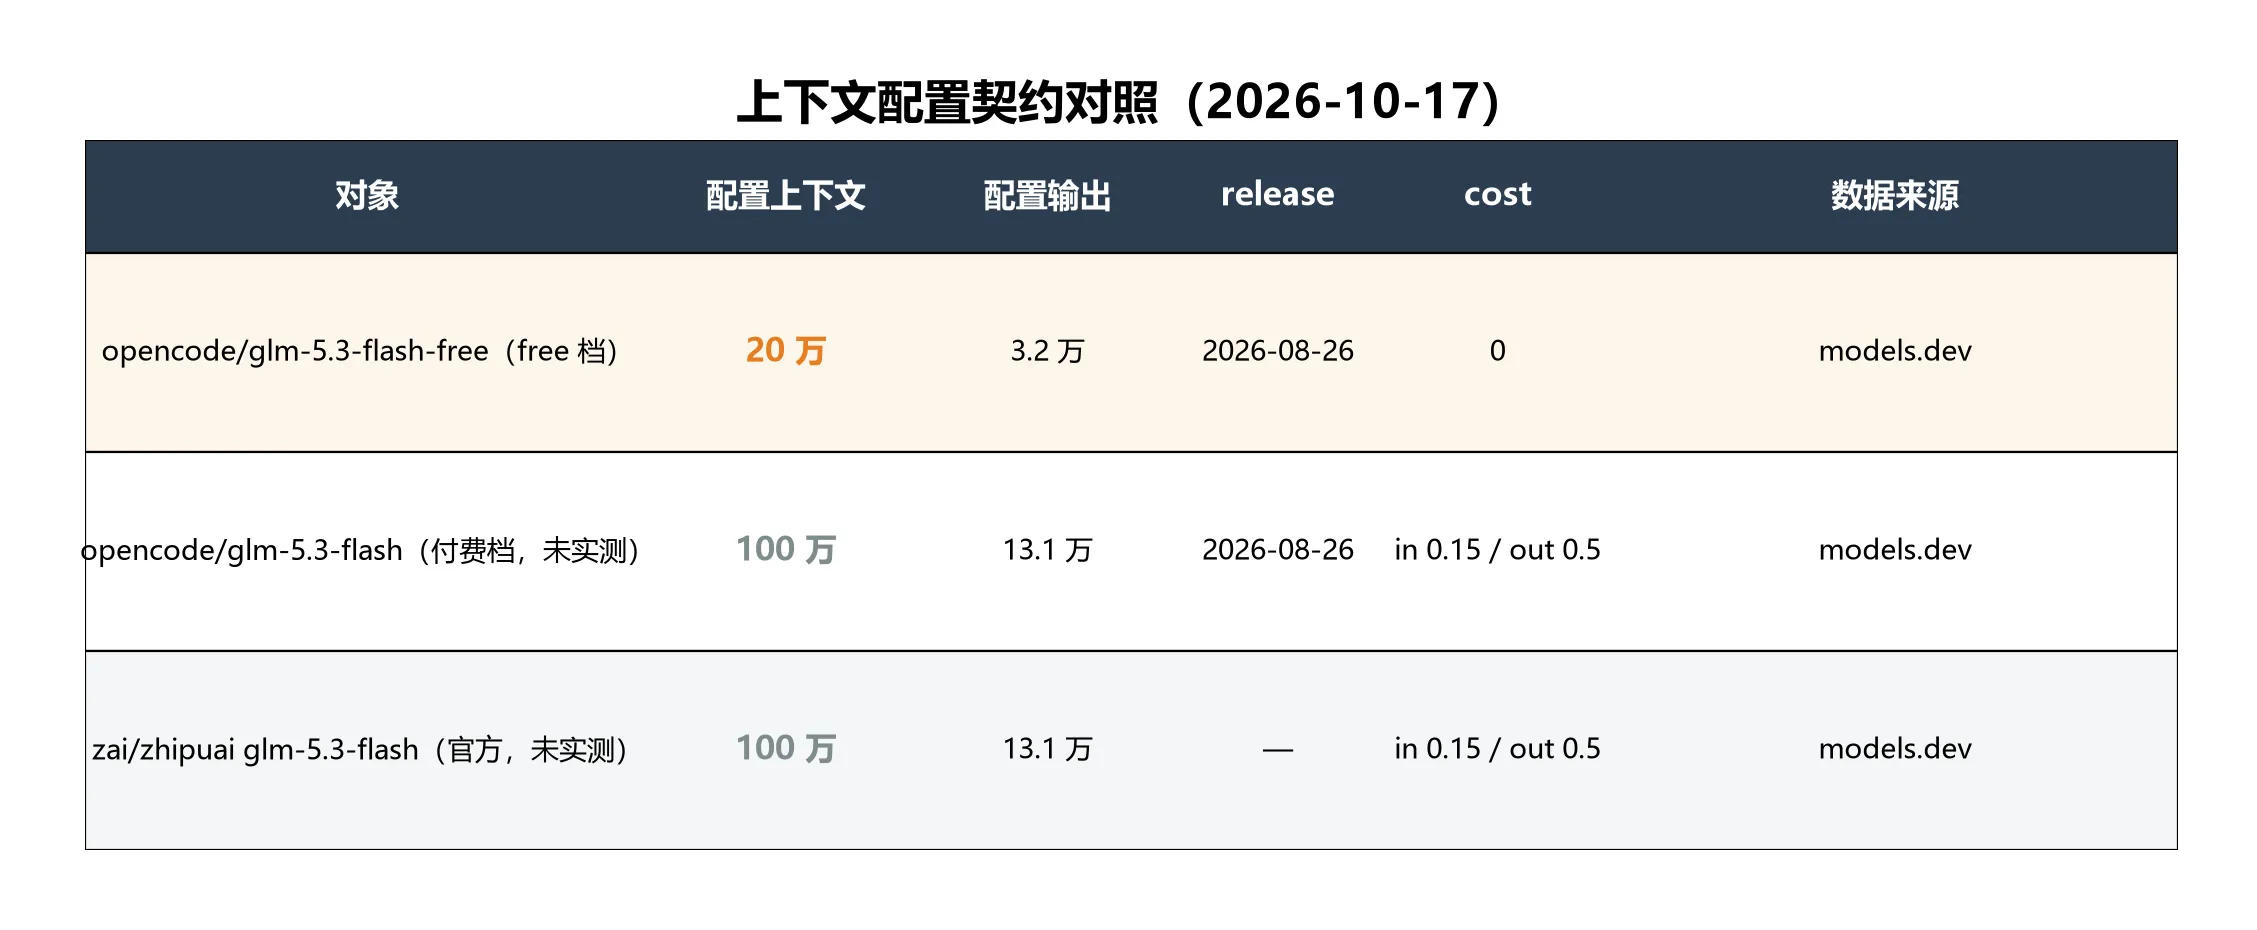
这次测的是 opencode 免费档位上的 glm-5.3-flash-free(models.dev release 2026-08-26,同型号付费档同一 release)。免费档、付费档、官方三处的配置对照:
| 对象 | 声明名 | 配置上下文 | 配置输出 | 参数/能力声明 | 端点 |
|---|---|---|---|---|---|
| free 档(本次实测) | GLM-5.3-Flash Free | 200,000(20 万) | 32,000(3.2 万) | reasoning(low/high/max);tool_call;structured_output;temperature | opencode.ai 免费端点 |
| 付费档(未实测) | GLM-5.3-Flash | 1,000,000(100 万) | 131,072(13.1 万) | 同族 glm-flash;release 同 2026-08-26 | opencode.ai 付费端点 |
| 官方(未实测) | GLM-5.3-Flash | 1,000,000(100 万) | 131,072(13.1 万) | models.dev 声明 | zai / zhipuai |
数据来源:models.dev。
二、上下文契约核验
配置层对照
free 档上下文配置 200K(20 万)≠ 付费/官方声明 100 万(1,000,000),输出 3.2 万(32,000)≠ 13.1 万(131,072)。差异出在服务配置这一层——不是模型权重被换了。
超 200K 实测
本地把 free 档配置上限从 20 万放开到 1,048,576(约 105 万)后实测;对照档保持默认 200K。方法:英文伪随机填充(约 5.29 字符/token 标定)+ 尾段藏秘密词,要求模型只输出该词,判断找回的标准是输出里命中藏好的秘密词。
| 档位 | 配置 | 服务端实际接受(tokens) | 秘密词找回 |
|---|---|---|---|
| 32K 冒烟 | 默认 200K | 50,922 | ✅ |
| 250K | 上限 105 万 | 270,733 | ✅ |
| 400K | 上限 105 万 | 424,394 | ✅ |
| 500K | 上限 105 万 | 521,737 | ✅ |
| 600K | 上限 105 万 | 618,810 | ❌ |
| 800K | 上限 105 万 | 813,626 | ❌(输出无关填充词 anisotropy) |
| 250K 对照 | 默认 200K | 271,242 | ✅(客户端自动压缩后找回,秘密词大小写变异) |
到底是谁在限制
| 问题 | 依据 | 结论 |
|---|---|---|
| 200K 是客户端软限制还是服务端硬限制? | ① 对照(默认 200K):服务端接受 271,242 未硬拒,客户端自动压缩后继续找回 ② 放开上限后 250K~800K 全接受 | 20 万 = 客户端/服务配置软限制(非服务端硬限制) |
| 服务端上下文实际上限 = ? | 最高实测 813,626 tokens 接受,未触达拒绝/截断 | 只能说 ≥81.4 万未触界(990K+/1000K+ 没测,给不出确切上限) |
| 800K 秘密词未找回 = 服务端拒绝? | 无任何错误事件,服务端接受并正常完成响应 | 不是服务端拒绝,是模型检索能力边界 |
三、检索能力边界
- 500K 找回(521,737,秘密词逐字输出)
- 600K 失守(618,810,模型输出分析文但未给秘密词——尝试定位但失败)
- 800K 失守(813,626,模型直接输出无关填充词
anisotropy——放弃检索)
随长度增大,检索失败形态从「尝试但错」退化为「放弃检索」。结论:检索能力边界落 500K~600K(截至 2026-10-17 实测,样本有限:600K/800K 各 1 次)。
与 DeepSeek 篇对比:同任务同场景(同一套实测构造思路)下,DeepSeek V4.1 Flash Free 在 800K 档找回(831,272);本次 GLM free 同档未找回。不同模型不是同一道题,谁高谁低不好下定论,这里只呈现行为差异。
四、家族一致信号(free 档 23 题)
| 组 | 结果 | 明细 |
|---|---|---|
| 特殊 token | 5/5 逐字回显 | `< |
| 能力 | 10/10 全部通过 | 推理(水箱 24h 附歧义标注、三段论附反例、一元二次 x=2,3 附验证);事实(Guido/HTTP 404/C# 2000 年);中文 200 字作文通畅;JSON 结构化合格;reasoning_tokens 出现 47~226 |
| 身份自报 | 记录 | 自报 GLM-5.3-Flash / 智谱 GLM / 载体 glm-5.3-flash-free;知识截止自报 2024-10;自报上下文 12.8 万,跟配置写的 20 万、放开后的 105 万都对不上 |
| 契约 | 3/3 | default/low/high 三种 variant 均接受,low/high 下 reasoning_tokens 出现(62/56) |
这一组信号看下来,free 档的行为跟 GLM 族/模型卡声明是对得上的——特殊 token 回显、能力剖面、variants 契约都正常。至于它跟付费档是不是同一套东西,这次没测付费档,我不下结论。
五、测试方法与局限
- 单机单场景:win32、opencode CLI 1.19.3、Python 3.12.10。
- 每档只测了 1 次:免费配额约束,不是稳定性测量。
- token 数为估算:5.29 字符/token 标定,精确 token 数以服务端实际接受值为准。
- 付费档/官方端点未实测:100 万仅为 models.dev 声明。
- 未覆盖:990K+ 细分边界、多模态输入、多轮长会话。
六、现在要不要用它
- 普通编码、日常任务:直接用。免费档行为正常,能力剖面与 GLM 族声明一致,特殊 token 回显、variants 契约都在。
- 大文档/长上下文任务:50 万以内可用(实测找到秘密词);60 万以上「服务端接得下、模型找不回」——长文检索别指望它。
- 冲着 80 万级上下文去:服务端接受但输出无关词,别当作 100 万档用。
- 时效提醒:免费档 10 月 16 号刚上架,配置随时可能调整。
- 还没弄清的:服务端硬上限到底多大(实测 ≥81.4 万未触界);它自报的上下文 12.8 万跟配置对不上。
关注微信公众号
扫码关注,第一时间获取软件更新动态与选型建议。