opencode 上线免费模型 Fledge Alpha Free:上线背景 + 能力实测(2026-10)
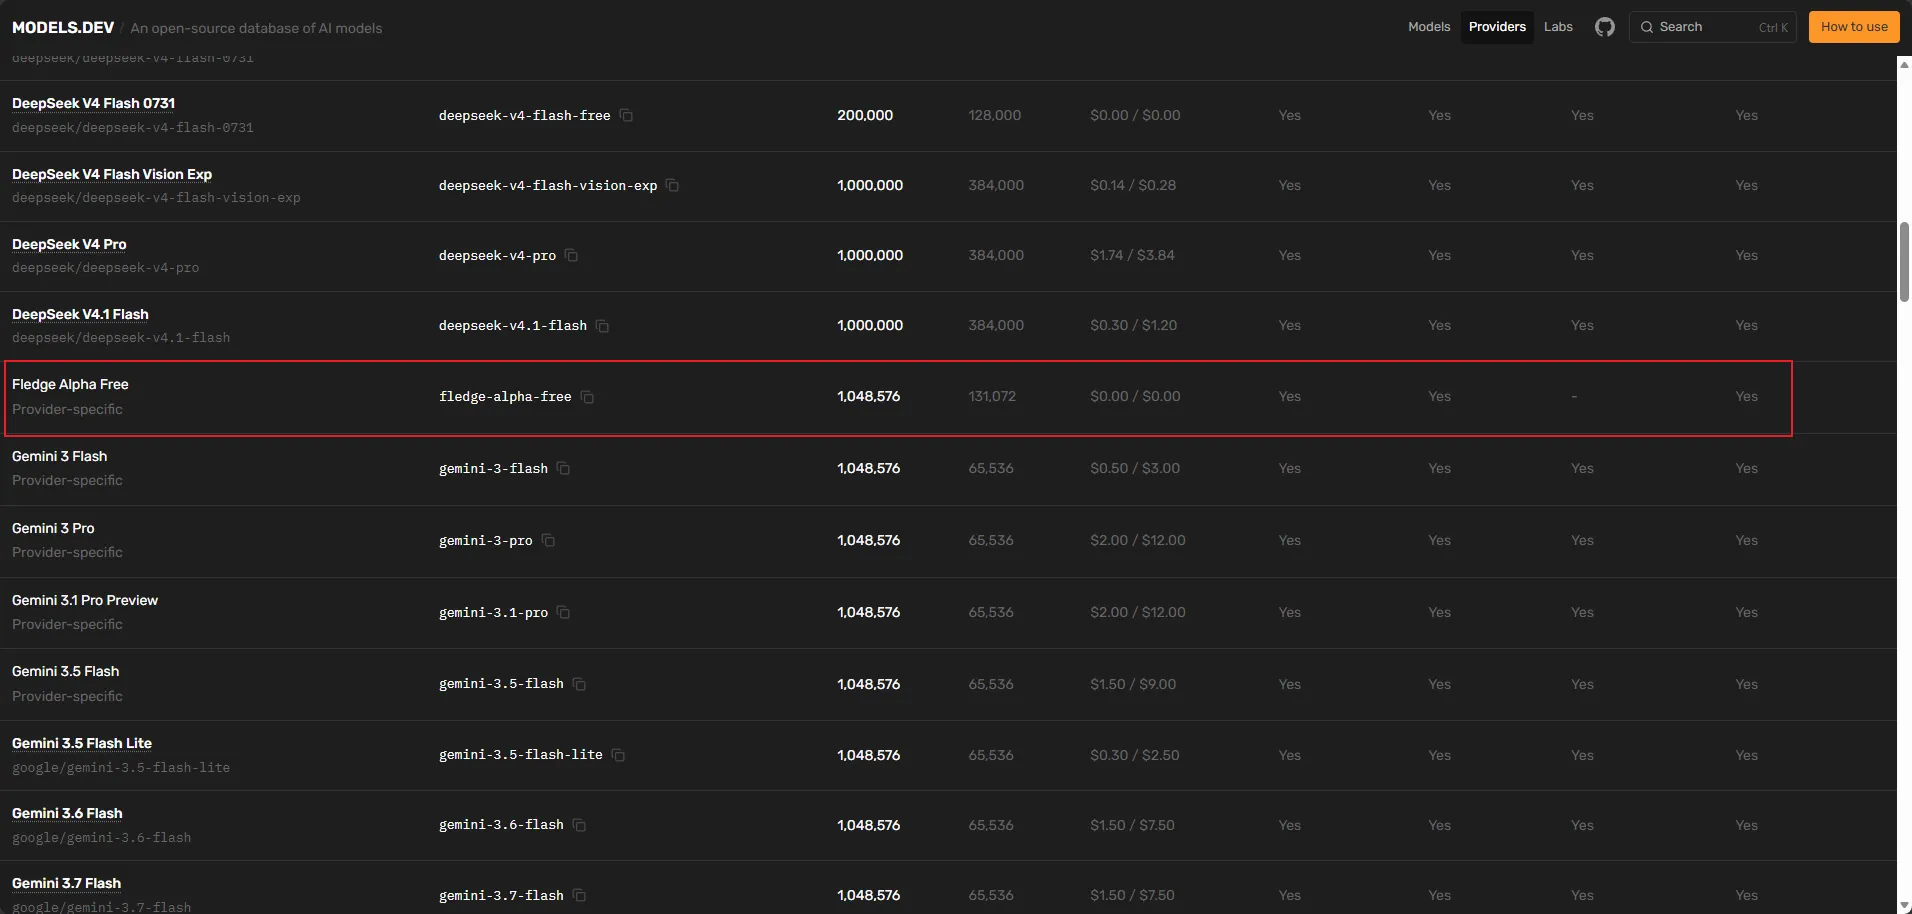
10 月 1 日,opencode 上架了一个免费模型:Fledge Alpha Free——$0、宣称 1M 上下文、支持图像和工具调用。社区第一反应是「DeepSeek 换皮?」本文基于 2026-10-04 的完整实测(58 次真实调用 + 2 轮对照 + 1 个真实修复任务),记录我看到的全部证据。结论放在前面:免费是真的,能力够日常用,「多模型路由」基本实锤,但具体是谁还没有证据。
一、成本与速度:白嫖确认
- 成本:42/42 次会话全部
cost=0,无任何隐藏扣费 - 速度:输出速度中位约 65.5 t/s(参考档位 <20 慢 / 20-80 中 / >80 快,属中速);首 token 毫秒级出字
- E2E:简单题 0.3-1.9s;代码/长输出任务 8-26s(输出 500-1350 token 场景)
二、能力剖面:基础项全过
| 维度 | 测法 | 结果 |
|---|---|---|
| 推理(3 题) | 水箱速率 / 逻辑三段论 / 一元二次方程 | 3/3 全对,步骤完整 |
| 事实性(5 题) | Python 之父 / HTTP 404 / C# 首发 / Git 创始人 / JSON 全称 | 5/5 全对,幻觉率 0% |
| 结构化输出(3 任务) | 简单对象 / 嵌套对象 / 含数组 | 3/3 直接 JSON 解析合规 |
| 稳定性(同 prompt ×10) | 同一句话重复 10 次 | 10/10 成功,隐藏发现见下文第三节 |
| 特殊 token 回显 | 6 种模板 token 要求逐字回显 | 4 个干净回显;`< |
三、路由发现:「不是单一模型」实锤
用同一句话(让模型重复输出一行文字)重复测试十几次,input token 计数出现三个稳定档位:
25995 / 32396 / 33818(跨次随机分布)同一平台、同一系统提示下,input 计数跨次跳变 → 请求被路由到了不同的后端执行。这与社区「Fledge = 多模型路由网关(疑 DeepSeek V4.1 + Kimi k3 + 未知)」的情报方向一致。
对照测试(两轮):我特意用 DeepSeek 和 Kimi 做了两轮指纹对照(mynvidia 与 mysensenova 两个渠道)。但发现跨平台 token 统计口径不一致——opencode(zen) 返回完整 input 计数,nvidia/火山等渠道返回「未命中缓存增量」(如 deepseek 的 input=74 + cache.read=27648)。绝对值不在同一基准,指纹直接比对不可行,未能指认具体是哪家的模型。这本身是这次评测的方法论发现:词表指纹法仅限同平台内使用。
能确认的:Fledge 不是单一模型,「多后端路由」证据充分;不能确认的:具体后端是谁(对照因口径不可比而悬置)。
四、干活能力:能修 bug,文档会「套模板」
修 bug(真实任务):让它修复一个 MAUI 俄罗斯方块游戏的旋转墙踢缺陷(原实现缺纵向墙踢,方块贴底时旋转失败)。交付的标准 SRS 墙踢表 16/16 条对照规范全部正确,逻辑验证通过(贴底场景:旧墙踢失败 → 新墙踢成功)。单轮成型,无中间错误。
写文档(暴露短板):让它写项目 README 初稿,构建步骤、玩法操作表全部正确;但项目结构目录套了通用模板——给的 Models/Services/Views 是 Web/MVVM 经典结构,实际项目是 MAUI Android(平铺的 App/GameLogic/GameView)。没拿到真实结构信息时,它按「看起来合理」的模板输出,未核对项目本身。
五、测试方法与判定标准
测试围绕几个维度展开,各维度的判定标准如下,读者可自行验证:
| 维度 | 怎么测 | 判定标准 |
|---|---|---|
| 推理 | 3 道文字题(含计算/逻辑/方程) | 答案正确且步骤完整自洽即过关 |
| 事实准确性 | 5 道常识题(人物/状态码/年份等) | 答案与公认事实一致即过关,答错或答不出计为异常 |
| 结构化输出 | 3 个任务要求只输出 JSON | 输出能直接按 JSON 解析且字段完整即过关,多余文字/尾逗号算违规 |
| 稳定性 | 同一句话重复 10 次 | 每次都能正常作答即过关;结果是否一致作为附加观察点 |
| 特殊 token | 6 个模板控制标记要求逐字回显 | 能原样回显即过关;吞掉或拒绝回显计入异常 |
| 速度/费用 | 记录每次耗时与 token 统计 | 价格按平台返回为准;速度按输出 token ÷ 耗时折算 |
过程里踩了两个坑,也如实交代:一是不同平台的 token 统计口径不一样,导致指纹比对没法做(见上文第三节);二是中文环境下的编码问题(测试时已规避)。这两个坑也划定了本文的结论边界——凡是证据够不着的判断,比如后端具体是哪几家,都只写到「存疑」,没有硬下断言。
六、怎么用它
- 个人项目 / 日常问答 / 写点小代码:完全可以。用免费的东西,有些不确定性很正常——同一个问题隔次再问,答案风格可能不一样(背后也许是不同的模型在回答),但实测下来,它给的推理、事实回答、真实修 bug,结果都是对的。对使用者来说,拿到对的结果就够了。
- 提交进重要代码、对外文档之前:多核一眼。它在代码和事实类任务上表现可靠,唯一露馅的是「没核对就套模板」的文档结构——这类产出,用之前顺手核一遍就行,不费什么事。
- 底层是谁:本文证据仅支持「多模型路由」一层;具体后端指认待官方说明或同平台词表指纹进一步验证。
全部数据为 2026-10-04 本人实测采集,测试方法与判定标准见上文第五节,可自行复测对照。